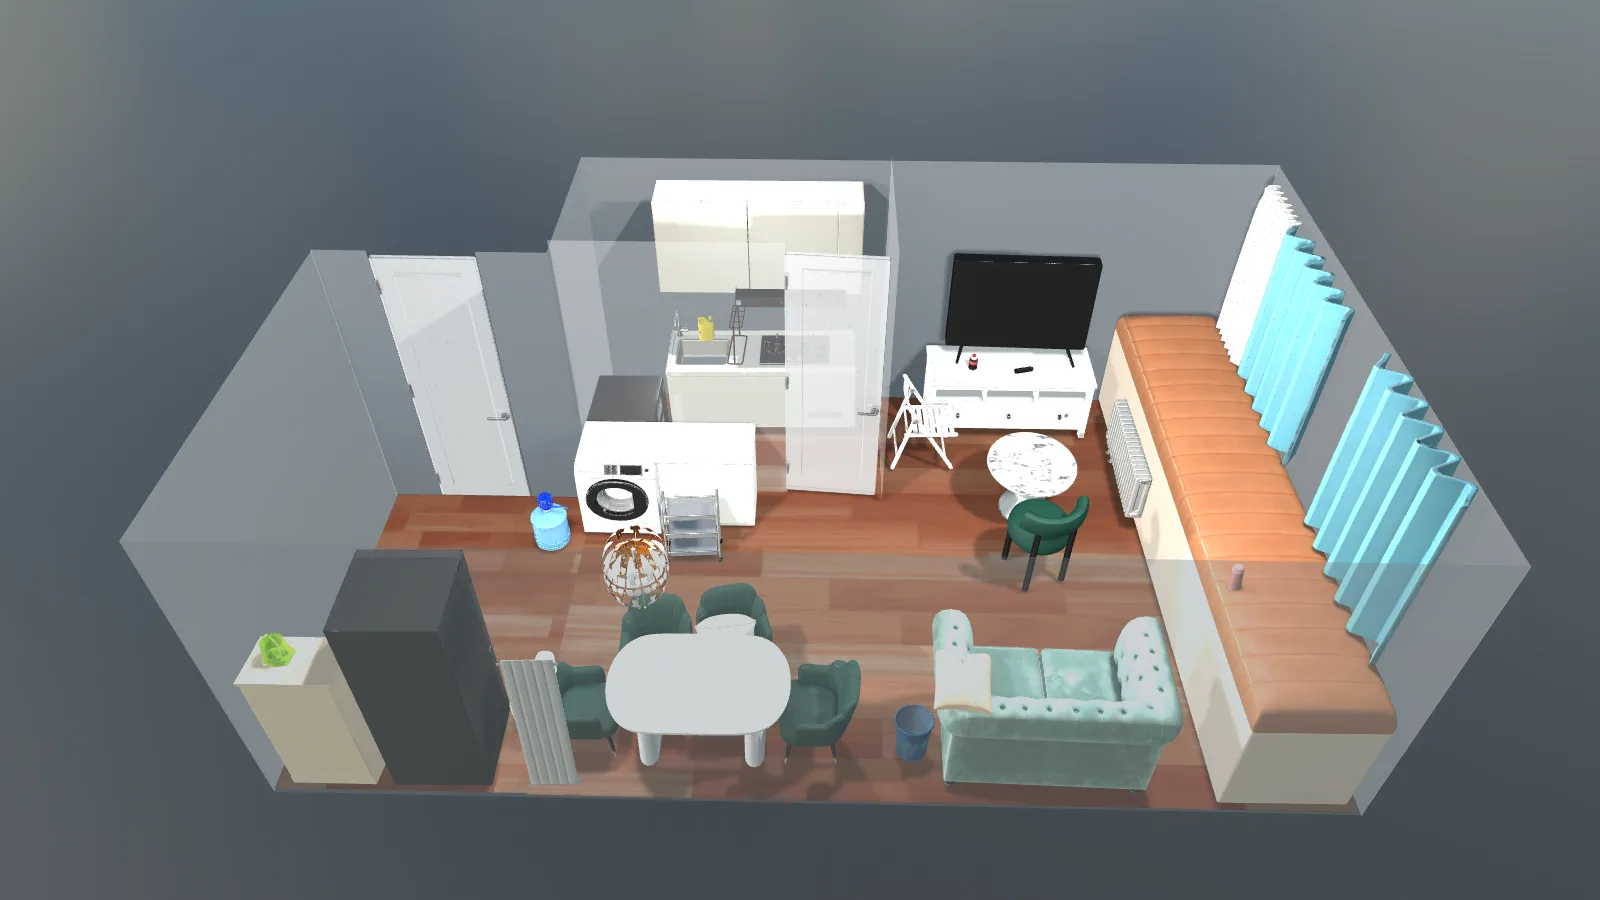
Lucida 是字节跳动 Seed 团队的场景建模系统。它不止生成一片融合点云,而是恢复独立物体资产,再按照拍摄时的位置组合成场景。核心价值不只是换个视角看房间,而是能逐个处理场景中的物体。
重建出来的场景是什么样
官方演示展示了从室内拍摄到场景重建的过程。结果中的物体是独立网格,而不是一整块难以拆开的场景表面,更适合数字孪生、仿真和场景编辑。
从看得到的片段恢复完整物体
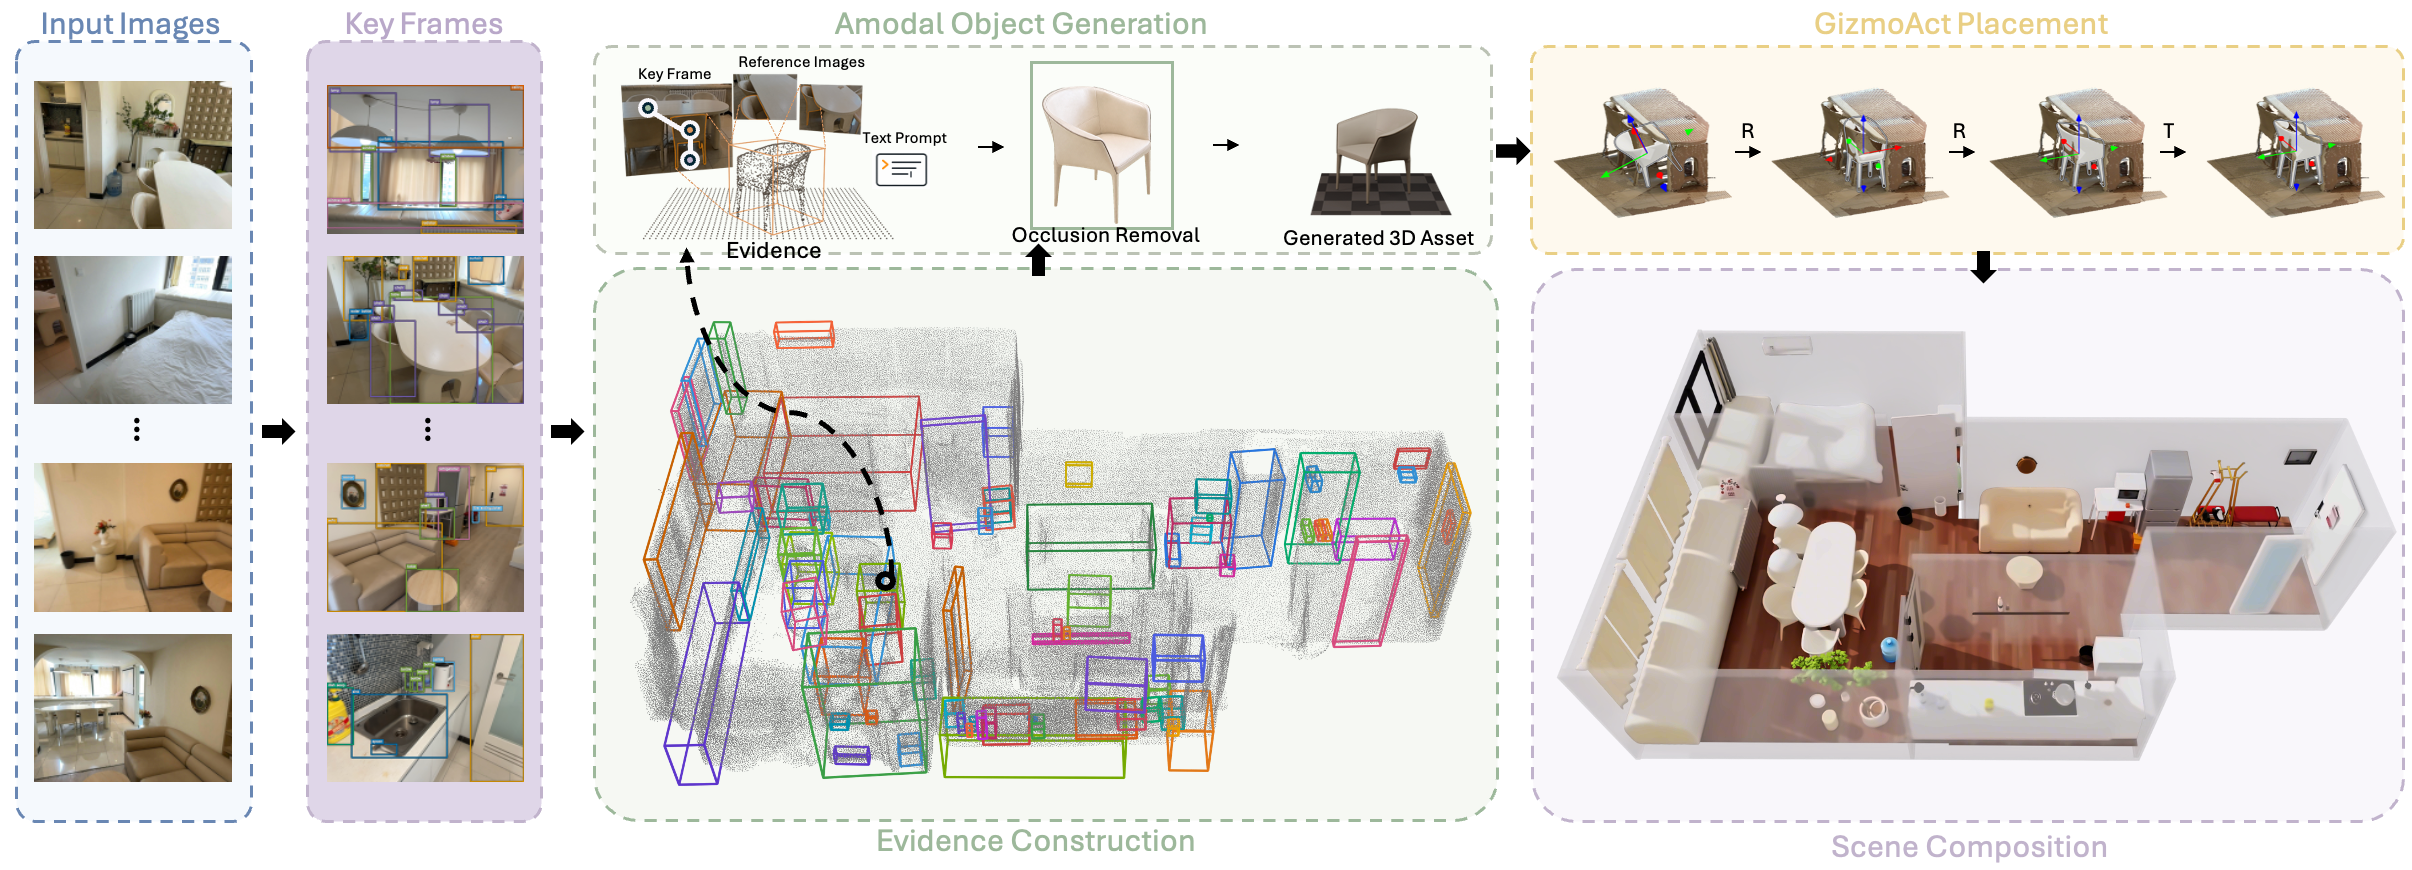
Lucida 先选择信息充分的视角,并关联不同画面中的同一个物体。参考图、遮罩、局部点云、3D 包围盒和语言描述共同组成每个物体的证据。
生成阶段先合成无遮挡的物体图像,再转成完整 3D 资产,补全被其他物体遮挡的部分。
GizmoAct:让物体摆到正确的位置
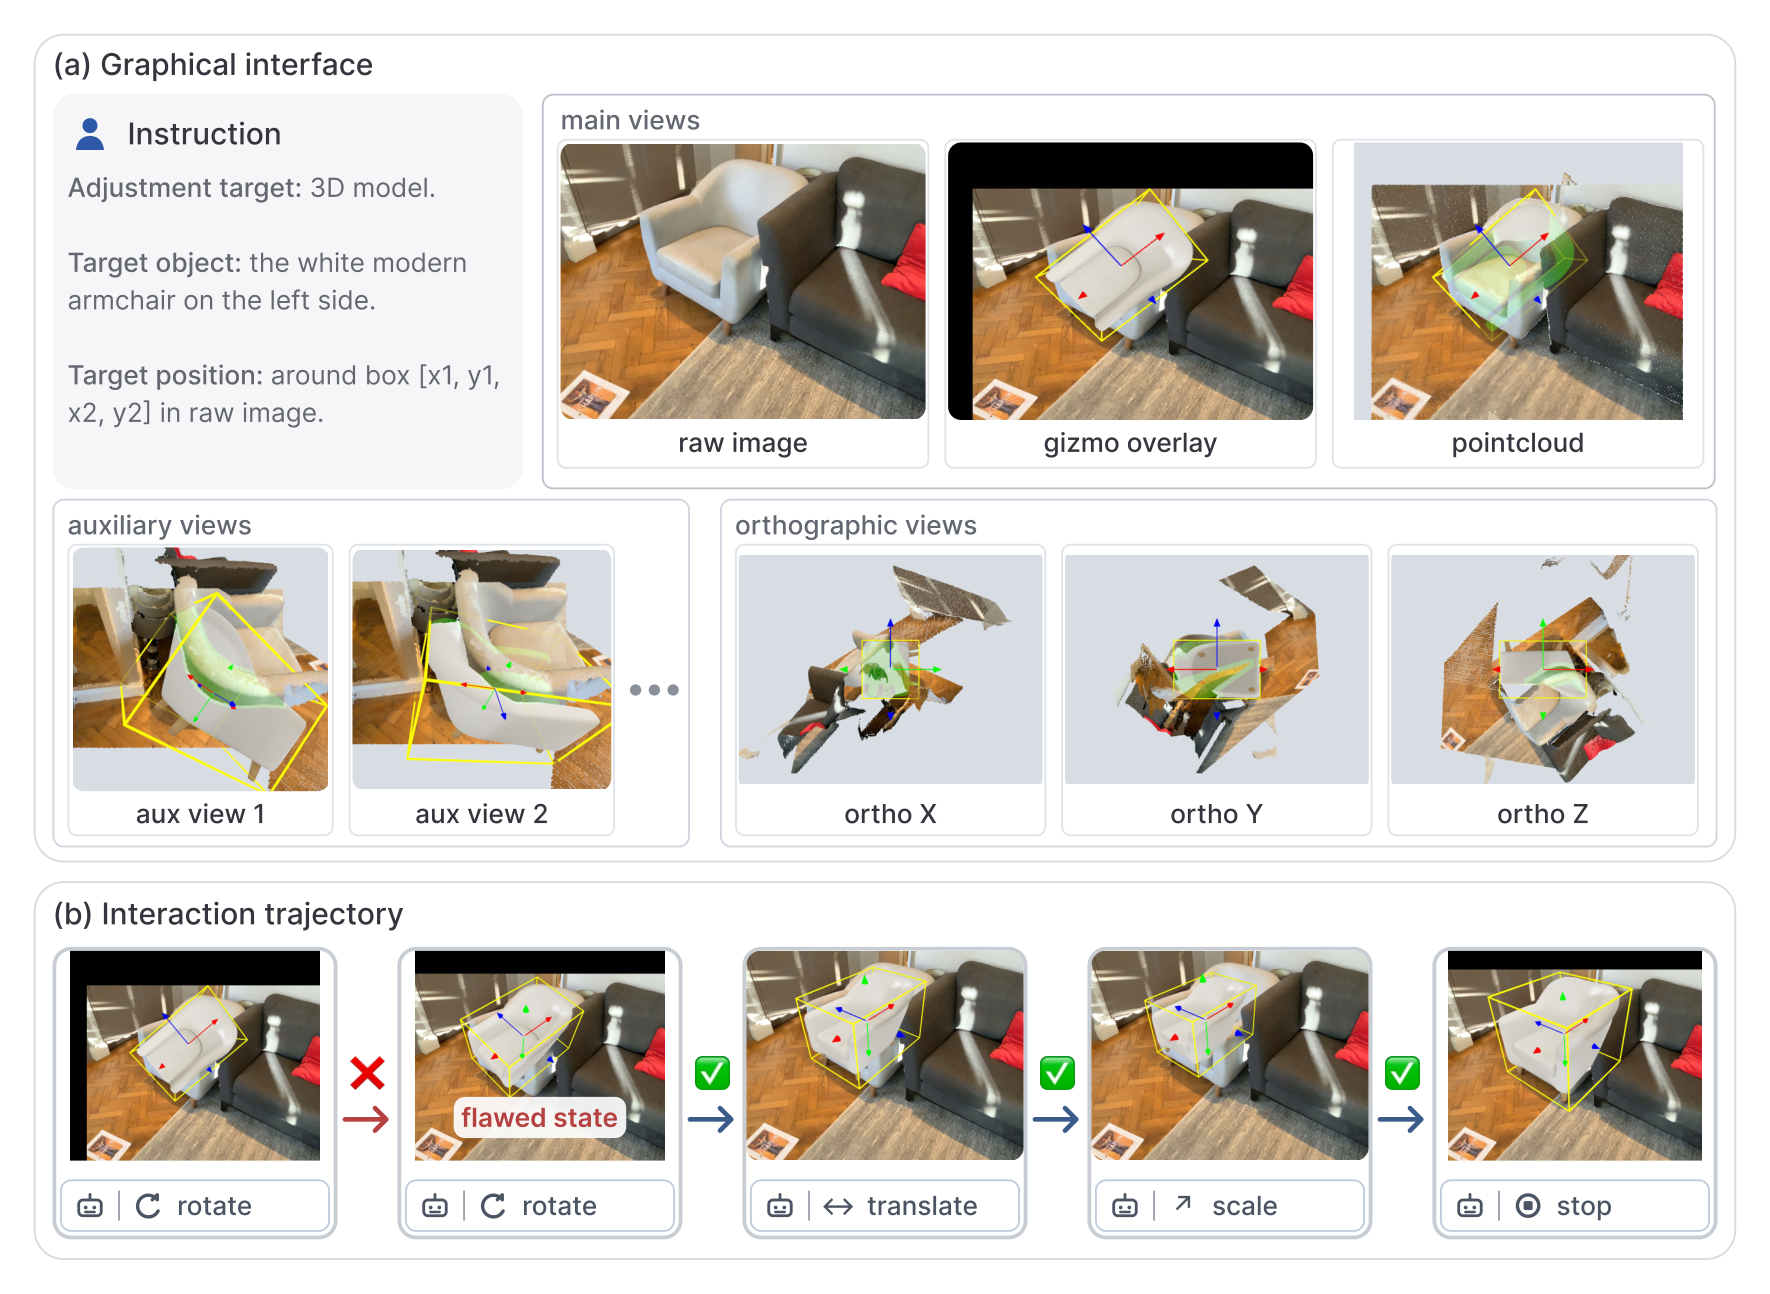
模型外观正确,不代表摆放位置和朝向也正确。GizmoAct 使用视觉语言模型检查渲染视图、点云叠加与局部坐标视图,再执行具体的姿态编辑。
每次修改后都对照原场景检查结果。它把“生成物体”和“摆放物体”分开处理,避免整个流程依赖上游一次生成完全准确的几何。
什么时候需要场景重建,什么时候只要生成资产
重建房间布局或 real-to-sim 环境时,物体身份、尺寸和摆放关系都很重要。保留独立资产,才能单独检查、替换或移动某个物体,而不用重新制作整个场景。
如果只需要一个商品、道具或角色,图片转 3D 更直接。先准备清晰的主体参考图;不需要周围环境时,没有必要走完整的房间重建流程。
独立物体场景与点云重建的区别
| 需求 | 点云重建 | Lucida |
|---|---|---|
| 表示方式 | 观察到的表面采样 | 独立、完整的物体资产 |
| 被遮挡区域 | 受拍摄到的表面限制 | 在物体生成阶段推断补全 |
| 编辑方式 | 处理场景几何或分割结果 | 逐个编辑物体网格 |
| 位置对齐 | 相机与几何配准 | 闭环视觉姿态修正 |
常见问题
Lucida 就是 Seed3D 2.0 吗?
不是。Lucida 关注如何从多视角观察组合出真实室内场景,Seed3D 2.0 关注 3D 资产生成。场景流程还需要关联物体、恢复尺寸并对齐位置。
被家具挡住的部分能精确还原吗?
看不到的几何会根据已有证据生成补全。它能得到完整资产,但不是对相机从未看到的表面进行测量。
Lucida 需要什么输入?
Lucida 结合同一室内场景的多视角、带相机位姿的观察。它关联不同画面中的物体,再用参考图、遮罩、局部点云和 3D 包围盒构建每个物体的证据。