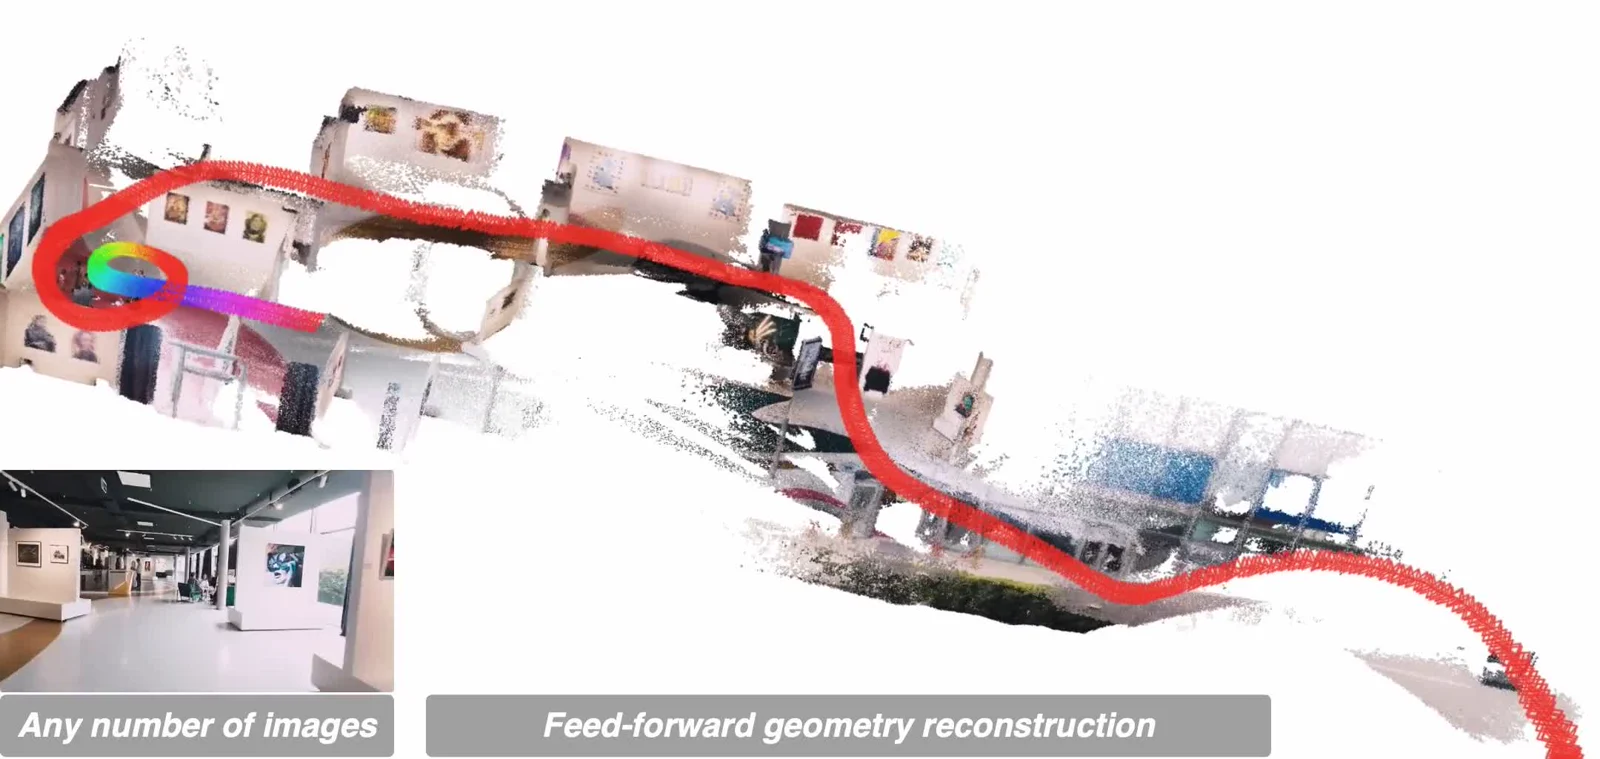
DA3 由字节跳动 Seed 团队开发,在共同的空间坐标系中估计多视角几何。统一的深度—射线表示既支持未知相机,也支持输入已知位姿,适用于场景采集、空间分析和新视角渲染。
DA3 能恢复什么
单图可以估计深度,多视角则增加跨画面的约束并估计相机。视频会按采样帧处理,因此结果连接的是不同观察,而不是一组互不相关的逐帧深度图。
输出包含深度、置信度、相机内参与外参。带高斯预测头的模型还可以输出 3D 高斯用于新视角渲染。先确定需要几何数据还是可观看的场景,再选择导出方式。
如何选择模型权重
多视角系列提供 Small、Base、Large 和 Giant。DA3Mono-Large 专注单图相对深度,DA3Metric-Large 面向真实尺度;Nested Giant-Large 把多视角几何与米制尺度结合起来。
Giant、Large、Nested 有新版时优先选 -1.1 权重。高斯输出由 Giant 和 Nested 支持,并非所有 DA3 模型都有。长视频可以用 DA3-Streaming 的滑动窗口降低显存压力。
运行图片或视频重建
克隆仓库,在 PyTorch 环境中安装项目。下方命令使用 Nested 1.1 处理图片目录,同时导出数值结果和 GLB 场景;首次运行会从 Hugging Face 下载权重。
视频使用 da3 video path/to/video.mp4,并用 --fps 控制采样帧率。先少量采样检查视角重叠与置信度,再增加覆盖范围。连续处理多个任务时,da3 backend 可以缓存模型,减少重复加载。
git clone https://github.com/ByteDance-Seed/Depth-Anything-3
cd Depth-Anything-3
pip install -e .

da3 auto path/to/images \
  --model-dir depth-anything/DA3NESTED-GIANT-LARGE-1.1 \
  --export-format mini_npz-glb \
  --export-dir output
导出后怎么用
GLB 导出的是带颜色点云的场景,可包含相机线框,并不自动变成拓扑整洁、封闭的物体网格。需要把深度、置信度与相机数组交给其他流程时,更适合使用 NPZ。
高斯 PLY 与渲染视角导出需要支持高斯的权重和对应依赖。若目标是能单独编辑家具、摆件的室内场景,Lucida 则采用逐物体重建与摆放的不同路线。
DA3、Depth Anything 2 与 Lucida 怎么选
| 工具 | 主要输入 | 适用任务 |
|---|---|---|
| Depth Anything 3 | 单图、多视角或视频帧 | 对齐的深度、相机与场景几何;部分模型支持 3D 高斯 |
| Depth Anything 2 | 单张图片 | 单目深度估计 |
| Lucida | 带位姿的室内观察 | 分物体的场景重建与对齐 |
常见问题
必须先知道相机位姿吗?
不需要。多视角模型可以估计相机;已有标定数据时,也能输入位姿进行条件重建。
所有模型都直接输出米制深度吗?
不是。Nested 输出真实尺度深度;DA3Metric-Large 需要按仓库说明结合焦距缩放。相对深度模型不能直接作为以米计的测量结果。
哪些 DA3 模型可以商用?
已发布的 Base、Small、Metric-Large、Mono-Large 权重采用 Apache 2.0;Giant、Large 与 Nested 采用 CC BY-NC 4.0。部署前确认所选具体权重的许可证。