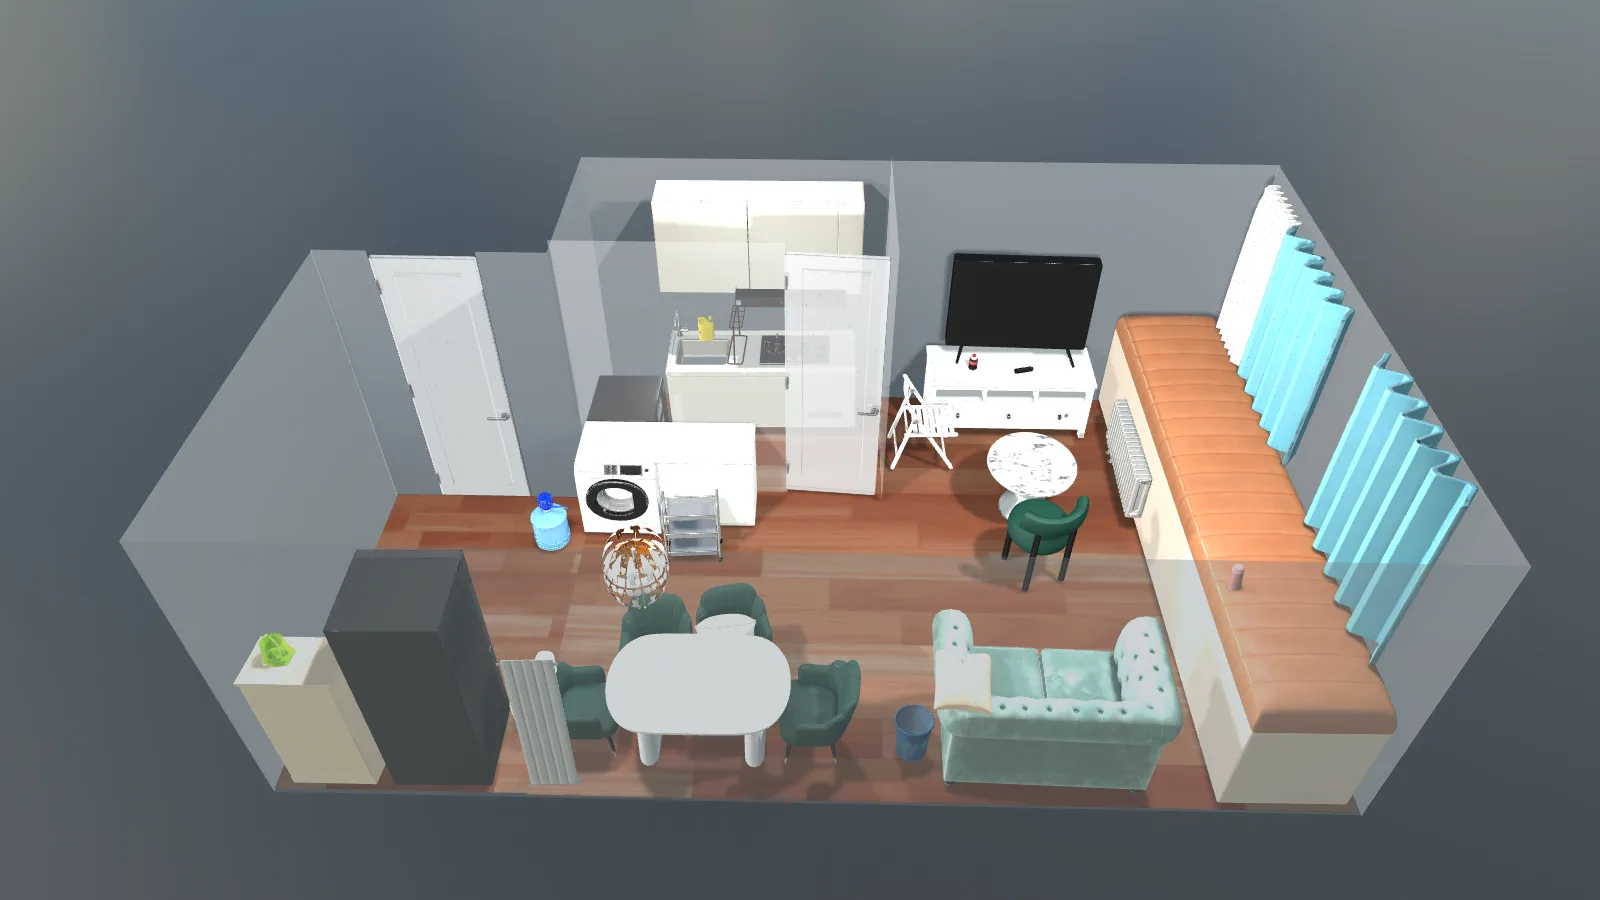
Lucida ist ein Szenenmodellierungssystem von ByteDance Seed. Statt nur eine zusammengeführte Punktwolke zu erzeugen, erstellt es einzelne Objekte und ordnet sie wie im aufgenommenen Raum an. Möbel bleiben separat bearbeitbar.
So sieht die Rekonstruktion aus
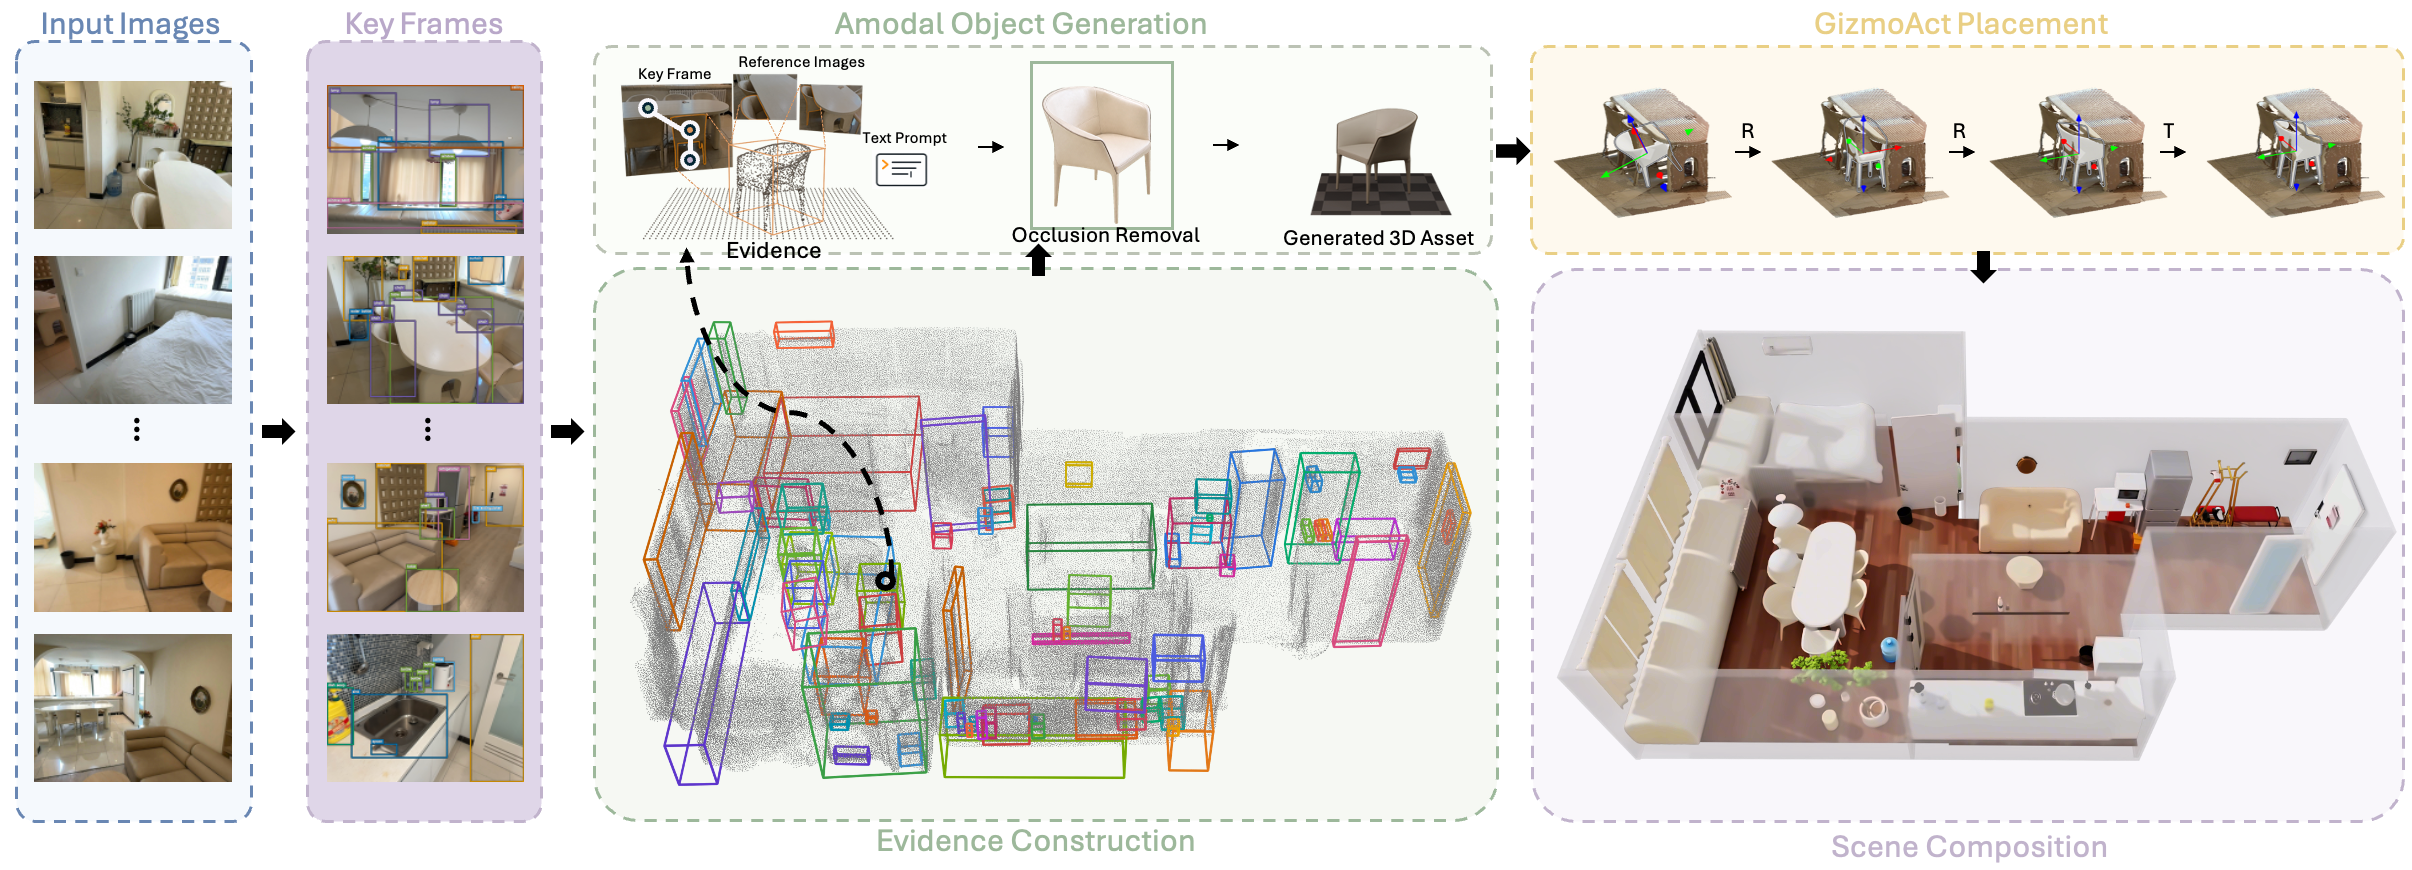
Das offizielle Video zeigt den Weg von Innenraumaufnahmen zur rekonstruierten Szene. Einzelne Objekte bestehen aus separaten Meshes statt einer untrennbaren Oberfläche – nützlich für digitale Zwillinge, Simulation und Szenenbearbeitung.
Sichtbare Fragmente zu vollständigen Objekten ergänzen
Lucida wählt informative Ansichten und verbindet Beobachtungen desselben Objekts. Referenzbilder, Masken, Teilpunktwolken, 3D-Boxen und Beschreibungen bilden die Grundlage.
Die Generierung erstellt zunächst ein unverdecktes Objektbild und daraus ein vollständiges 3D-Asset mit ergänzten verdeckten Bereichen.
GizmoAct richtet die Objekte im Raum aus
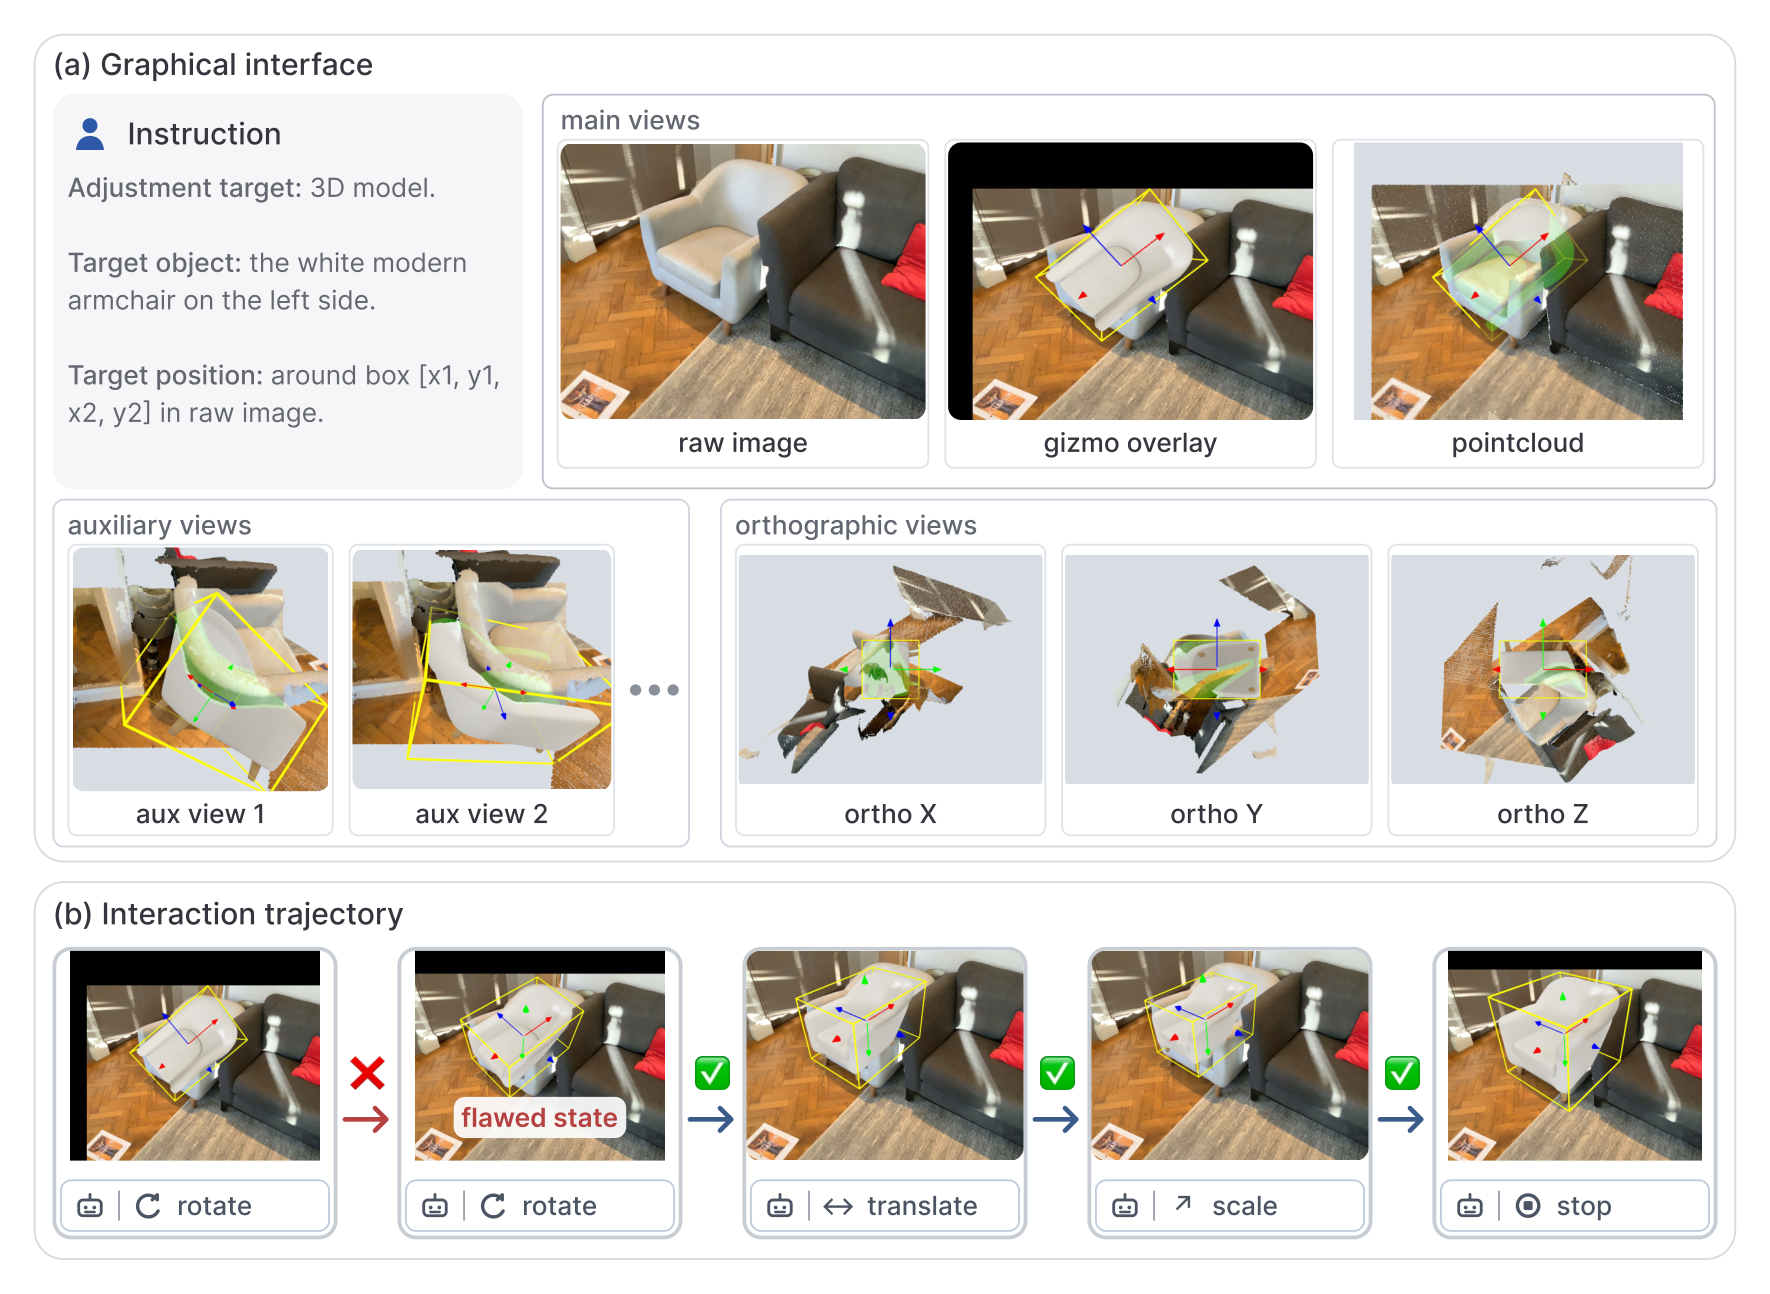
Ein gutes Modell kann trotzdem falsch stehen. Ein Vision-Language-Modell prüft Renderbilder, Punktwolken-Überlagerungen und lokale Achsen und führt konkrete Poseänderungen aus.
Die Schleife vergleicht jede Änderung mit der Aufnahme. Generierung und Platzierung bleiben getrennt, damit nicht jeder frühere Schritt perfekte Geometrie liefern muss.
Szenenrekonstruktion oder einzelnes Asset?
Bei Raumlayouts und Real-to-Sim sind Identität, Maßstab und Position gemeinsam wichtig. Separate Assets lassen sich austauschen oder verschieben, ohne die ganze Szene neu aufzubauen.
Für ein einzelnes Produkt, Requisit oder eine Figur ist Bild-zu-3D direkter. Nutze ein klares Referenzbild, wenn die Umgebung nicht benötigt wird.
Objektbasierte Szenen und Punktwolken
| Bedarf | Punktwolkenrekonstruktion | Lucida |
|---|---|---|
| Darstellung | Beobachtete Oberflächenpunkte | Separate vollständige Objekte |
| Verdeckte Bereiche | Auf Beobachtungen beschränkt | Durch Generierung ergänzt |
| Bearbeitung | Szenengeometrie oder Segmentierung | Einzelne Objekt-Meshes |
| Ausrichtung | Kamera- und Geometrieregistrierung | Visuelle Posekorrektur in einer Schleife |
Häufige Fragen
Ist Lucida dasselbe wie Seed3D 2.0?
Nein. Lucida setzt eine Szene aus mehreren Beobachtungen zusammen. Seed3D 2.0 erzeugt Assets; eine Szene braucht zusätzlich Objektzuordnung, Maßstab und Platzierung.
Sind unsichtbare Flächen exakt?
Sie werden aus den vorhandenen Informationen generiert, nicht direkt von der Kamera vermessen.
Welche Eingaben verwendet Lucida?
Lucida kombiniert mehrere Beobachtungen desselben Innenraums mit bekannten Kameraposen. Es ordnet Objekte über die Ansichten hinweg zu und sammelt Referenzbilder, Masken, Teilpunktwolken und 3D-Boxen als Grundlage für jedes Objekt.