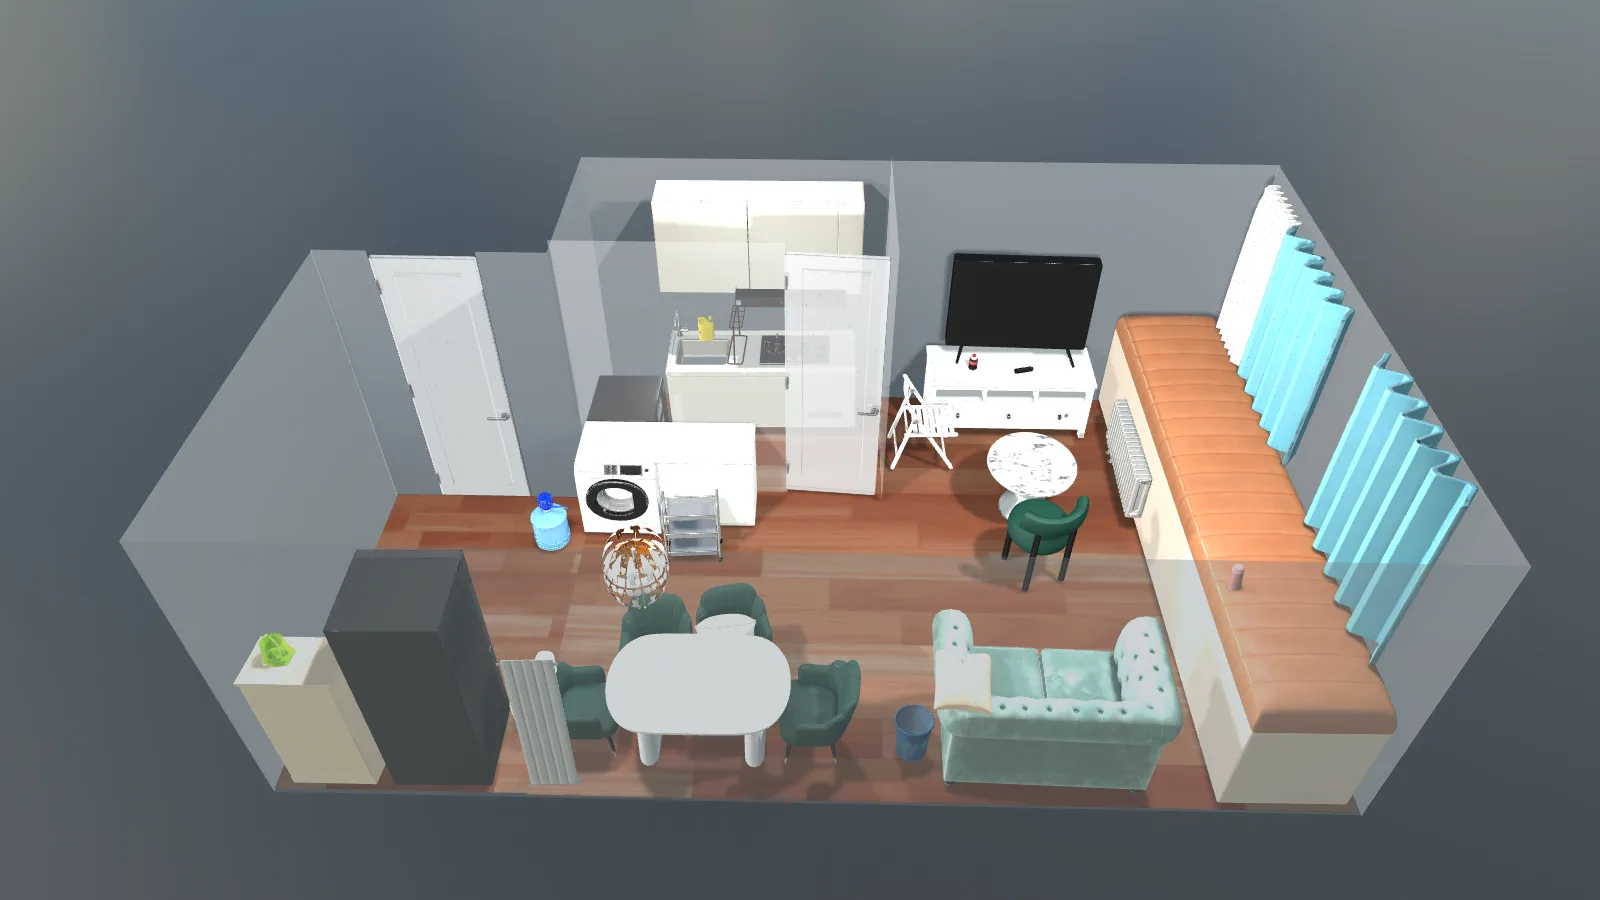
O Lucida é um sistema de cenas da ByteDance Seed. Em vez de parar numa nuvem de pontos unificada, recupera objetos separados e os posiciona como na captura. Cada móvel continua editável individualmente.
Como fica a reconstrução
O vídeo oficial acompanha uma captura de interiores até a cena reconstruída. Os objetos são malhas separadas, não uma superfície única inseparável: útil para gêmeos digitais, simulação e edição.
Dos fragmentos visíveis aos objetos completos
O Lucida seleciona vistas informativas e associa o mesmo objeto entre elas. Imagens, máscaras, nuvens parciais, caixas 3D e descrições formam as evidências.
A geração cria uma imagem do objeto sem oclusão e depois um recurso 3D completo, preenchendo as partes ocultas.
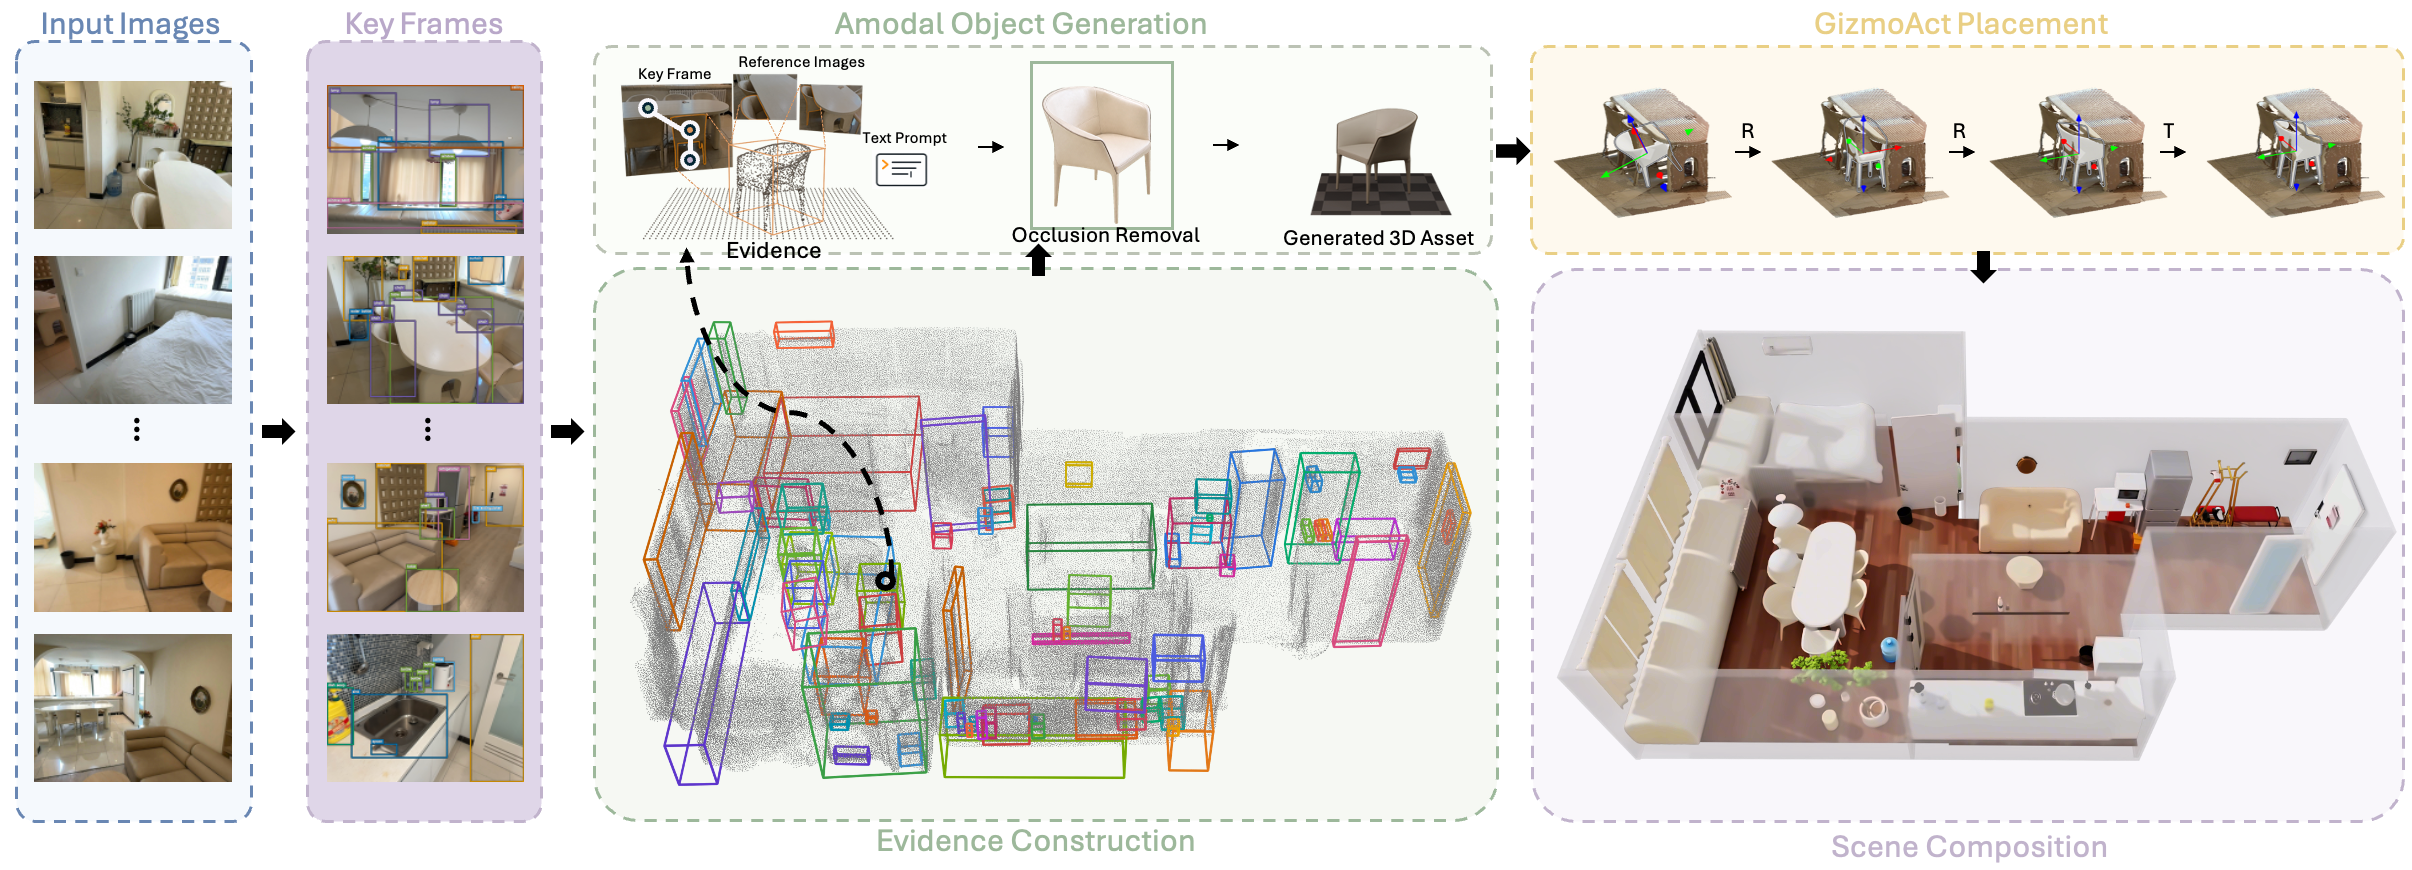
GizmoAct: colocar cada objeto no lugar
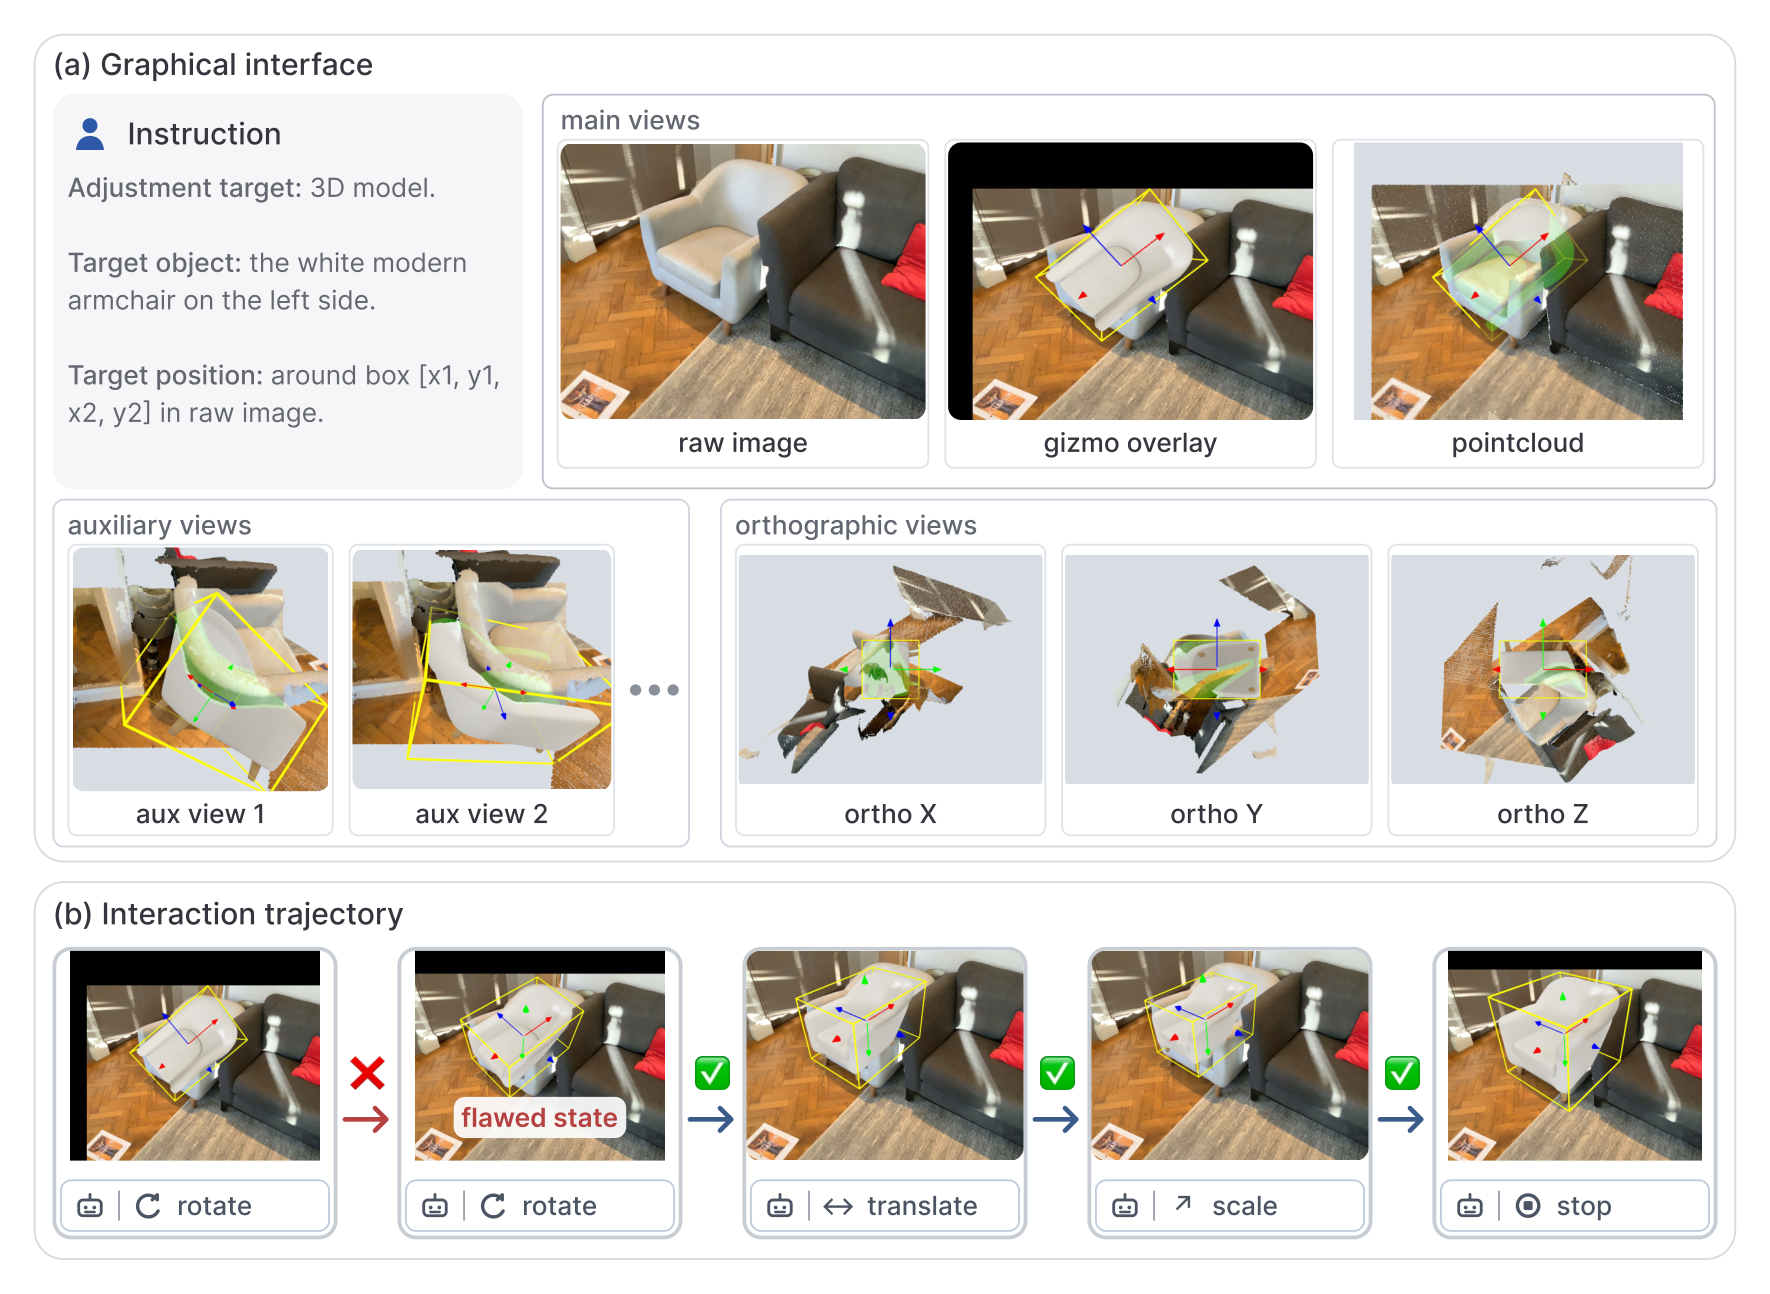
Um modelo plausível pode estar mal orientado. Um modelo de visão e linguagem examina renderizações, pontos sobrepostos e eixos locais para executar ajustes de pose.
O ciclo compara cada alteração com a captura. Separar geração e posicionamento evita exigir geometria perfeita desde as primeiras etapas.
Quando reconstruir uma cena ou gerar apenas um objeto
Em salas e ambientes real-to-sim, identidade, escala e posição importam juntas. Objetos separados permitem substituir ou mover um móvel sem refazer tudo.
Para um produto, adereço ou personagem isolado, imagem para 3D é mais direto. Prepare uma referência nítida quando não precisar do ambiente.
Cenas por objetos e nuvens de pontos
| Necessidade | Nuvem de pontos | Lucida |
|---|---|---|
| Representação | Amostras das superfícies observadas | Objetos completos separados |
| Regiões ocultas | Limitadas pelas observações | Completadas por geração |
| Edição | Geometria global ou segmentação | Malhas individuais |
| Alinhamento | Registro de câmeras e geometria | Refinamento visual em ciclo |
Perguntas frequentes
Lucida é o Seed3D 2.0?
Não. O Lucida compõe cenas a partir de várias observações. O Seed3D 2.0 gera objetos; uma cena também precisa de associação, escala e posicionamento.
As superfícies ocultas são exatas?
São geradas a partir das evidências disponíveis, não medidas diretamente pela câmera.
Quais entradas o Lucida utiliza?
O Lucida combina várias observações do mesmo ambiente interno com suas poses de câmera. Associa objetos entre vistas e reúne imagens de referência, máscaras, nuvens parciais e caixas 3D para cada objeto.