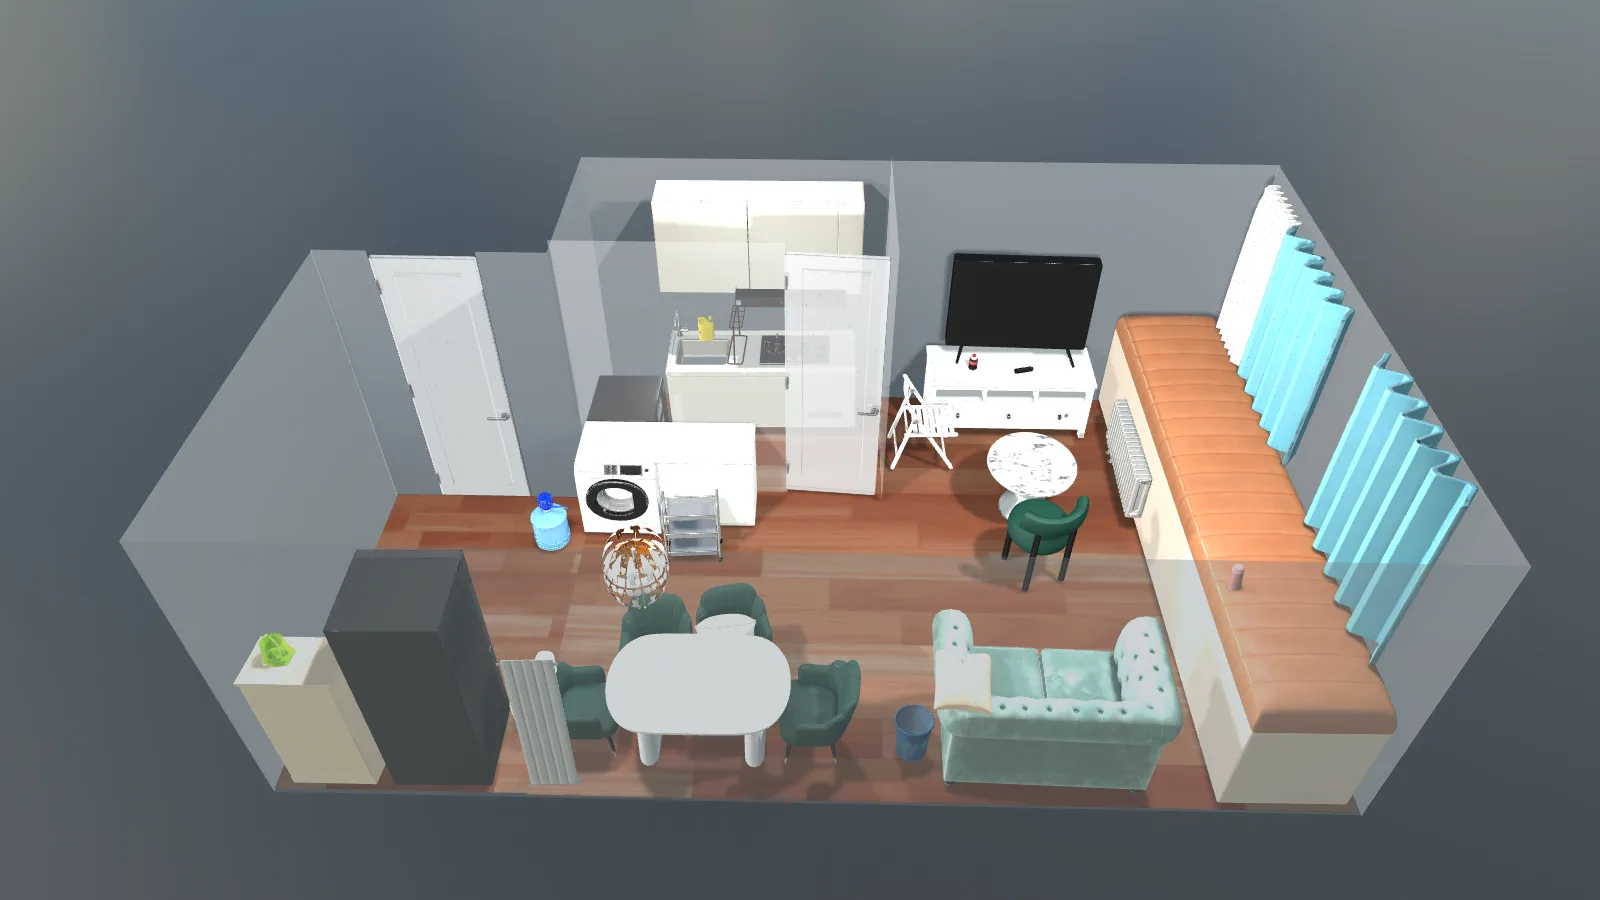
Lucida는 ByteDance Seed의 장면 모델링 시스템입니다. 합쳐진 점군에서 끝나지 않고, 독립된 객체를 복원해 촬영 당시 배치대로 놓습니다. 가구를 개별적으로 다룰 수 있다는 점이 핵심입니다.
복원된 장면은 어떤 모습인가요?
공식 영상은 실내 촬영이 복원 장면으로 바뀌는 과정을 보여줍니다. 결과는 분리하기 어려운 단일 표면이 아니라 독립된 객체 메시로 구성되어 디지털 트윈, 시뮬레이션과 편집에 유용합니다.
보이는 조각으로 완전한 객체 만들기
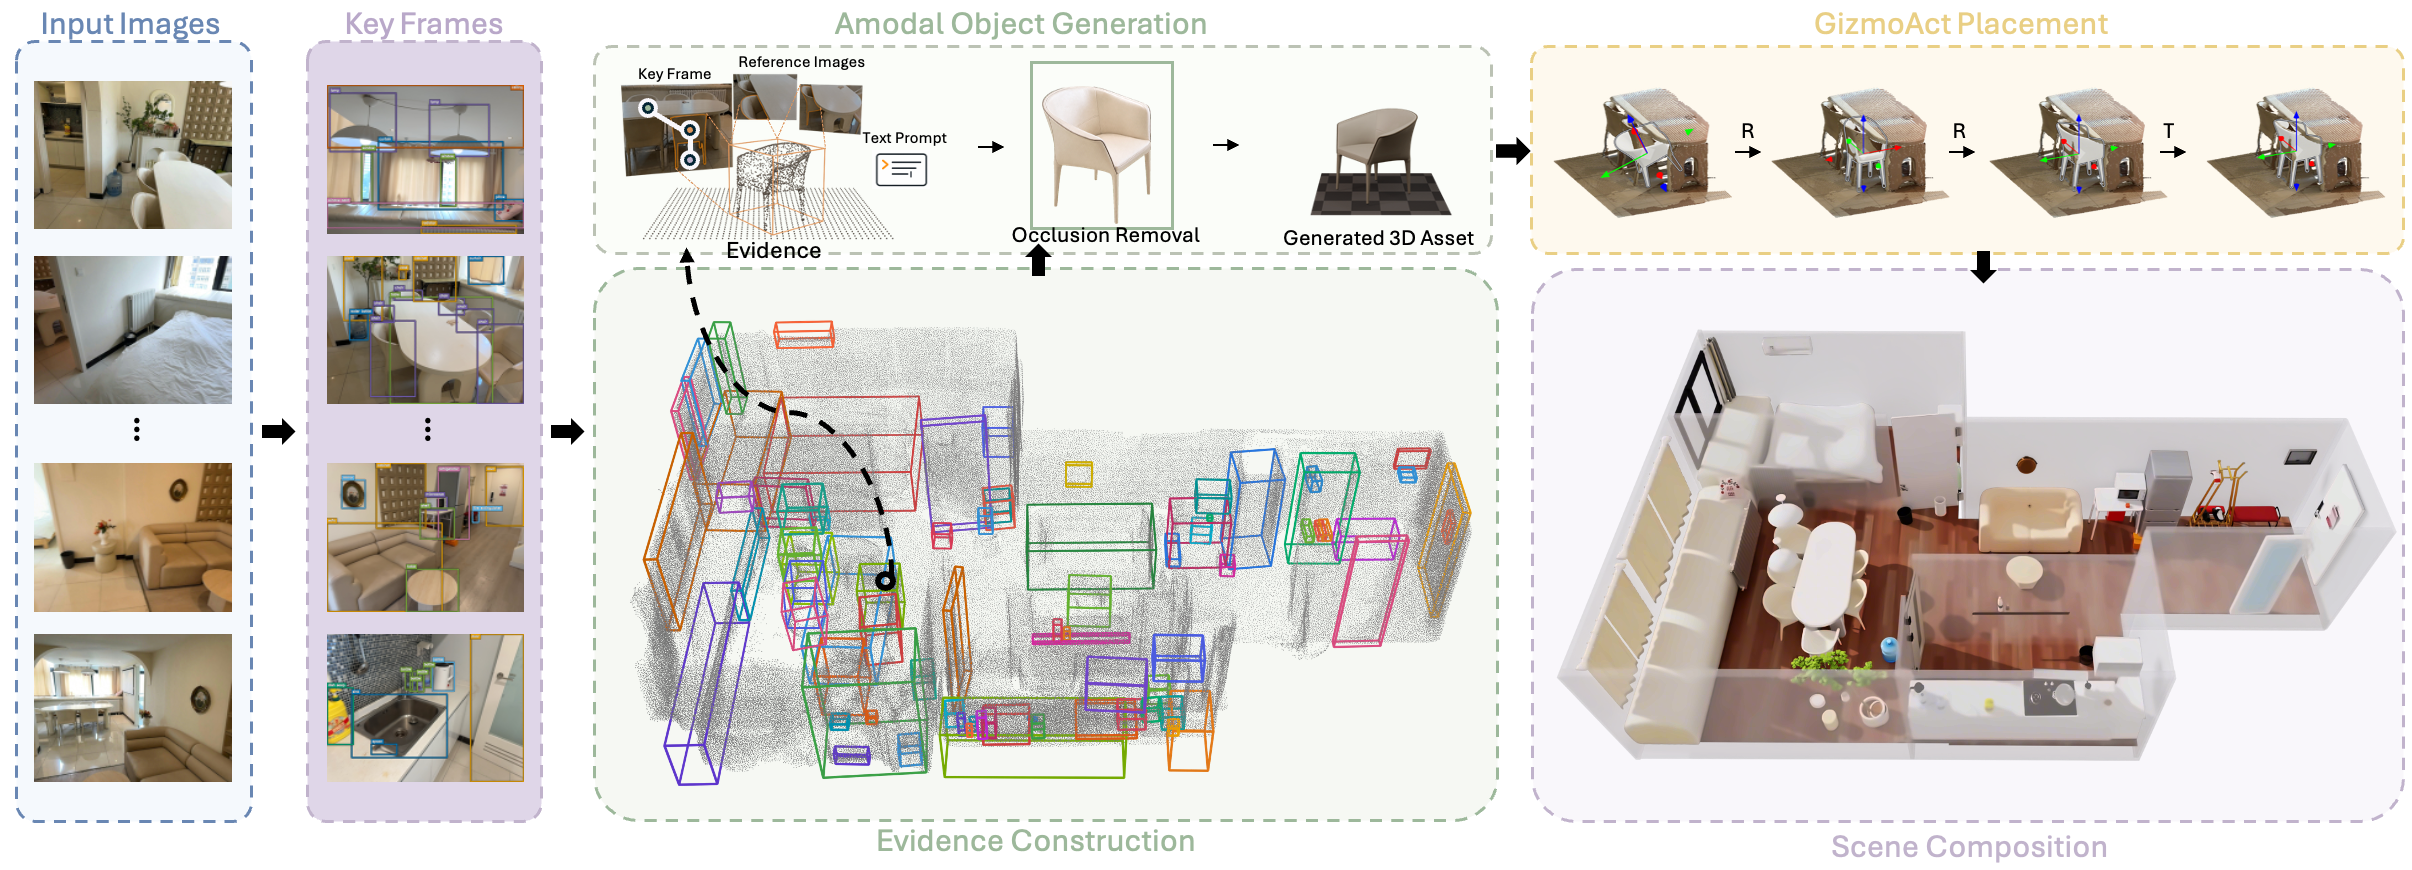
정보가 풍부한 시점을 선택하고 여러 이미지의 같은 객체를 연결합니다. 참고 이미지, 마스크, 부분 점군, 3D 박스와 설명이 객체별 증거를 구성합니다.
생성 단계는 가림 없는 물체 이미지를 만든 뒤, 가려진 부분을 채운 완전한 3D 에셋으로 변환합니다.
GizmoAct로 객체 위치와 방향 맞추기
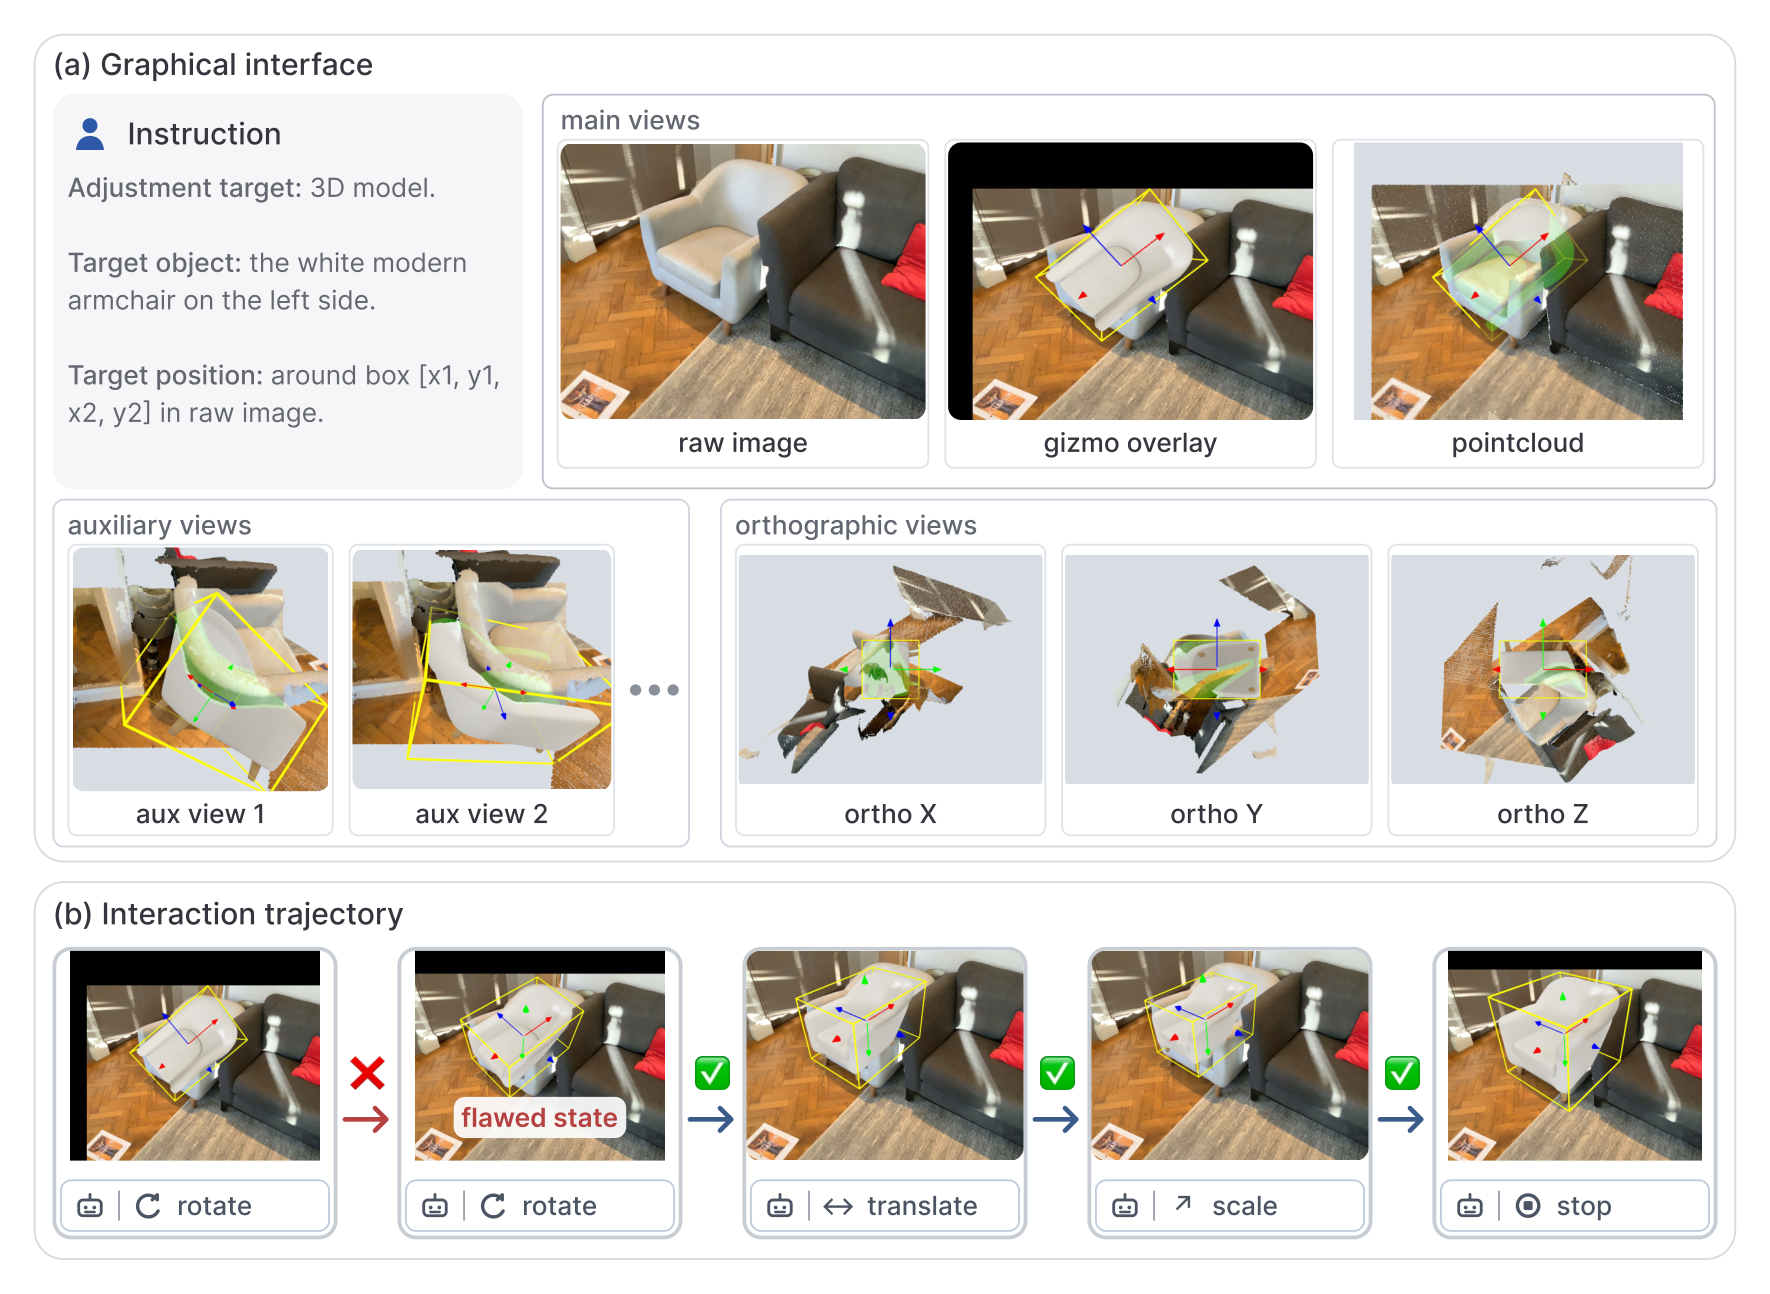
모양이 올바르더라도 배치는 틀릴 수 있습니다. 비전 언어 모델이 렌더링, 점군 오버레이와 로컬 축을 확인하고 실행 가능한 자세 수정을 내립니다.
수정 후 결과를 원래 촬영과 비교하는 루프입니다. 생성과 배치를 분리해 초기 단계부터 완벽한 기하를 요구하지 않습니다.
장면 복원과 단일 자산 생성의 선택
방이나 real-to-sim 환경에서는 객체 식별, 크기와 배치가 함께 중요합니다. 독립 자산이라면 전체 장면을 다시 만들지 않고 가구를 교체하거나 움직일 수 있습니다.
제품, 소품이나 캐릭터 하나만 필요하다면 이미지에서 3D 생성이 더 직접적입니다. 주변 환경이 필요 없을 때는 선명한 대상 이미지를 준비하세요.
객체 기반 장면과 점군 복원
| 요구 | 점군 복원 | Lucida |
|---|---|---|
| 표현 | 관측한 표면의 샘플 | 독립된 완전한 객체 |
| 가려진 부분 | 촬영된 관측에 제한 | 생성 단계에서 추정 보완 |
| 편집 | 장면 기하 또는 분할 결과 | 개별 객체 메시 |
| 정렬 | 카메라와 기하 등록 | 시각 피드백 기반 자세 수정 |
자주 묻는 질문
Lucida가 Seed3D 2.0인가요?
아닙니다. Lucida는 여러 관측으로 장면을 구성하고, Seed3D 2.0은 자산을 생성합니다. 장면에는 객체 연결, 크기와 배치도 필요합니다.
숨은 표면도 정확한가요?
사용 가능한 증거로 생성하므로 카메라가 직접 측정한 결과는 아닙니다.
Lucida는 어떤 입력을 사용하나요?
Lucida는 카메라 포즈가 포함된 동일 실내 장면의 여러 관측을 결합합니다. 시점 간 물체를 연결한 뒤 참조 이미지, 마스크, 부분 포인트 클라우드, 3D 박스를 물체별 근거로 구성합니다.