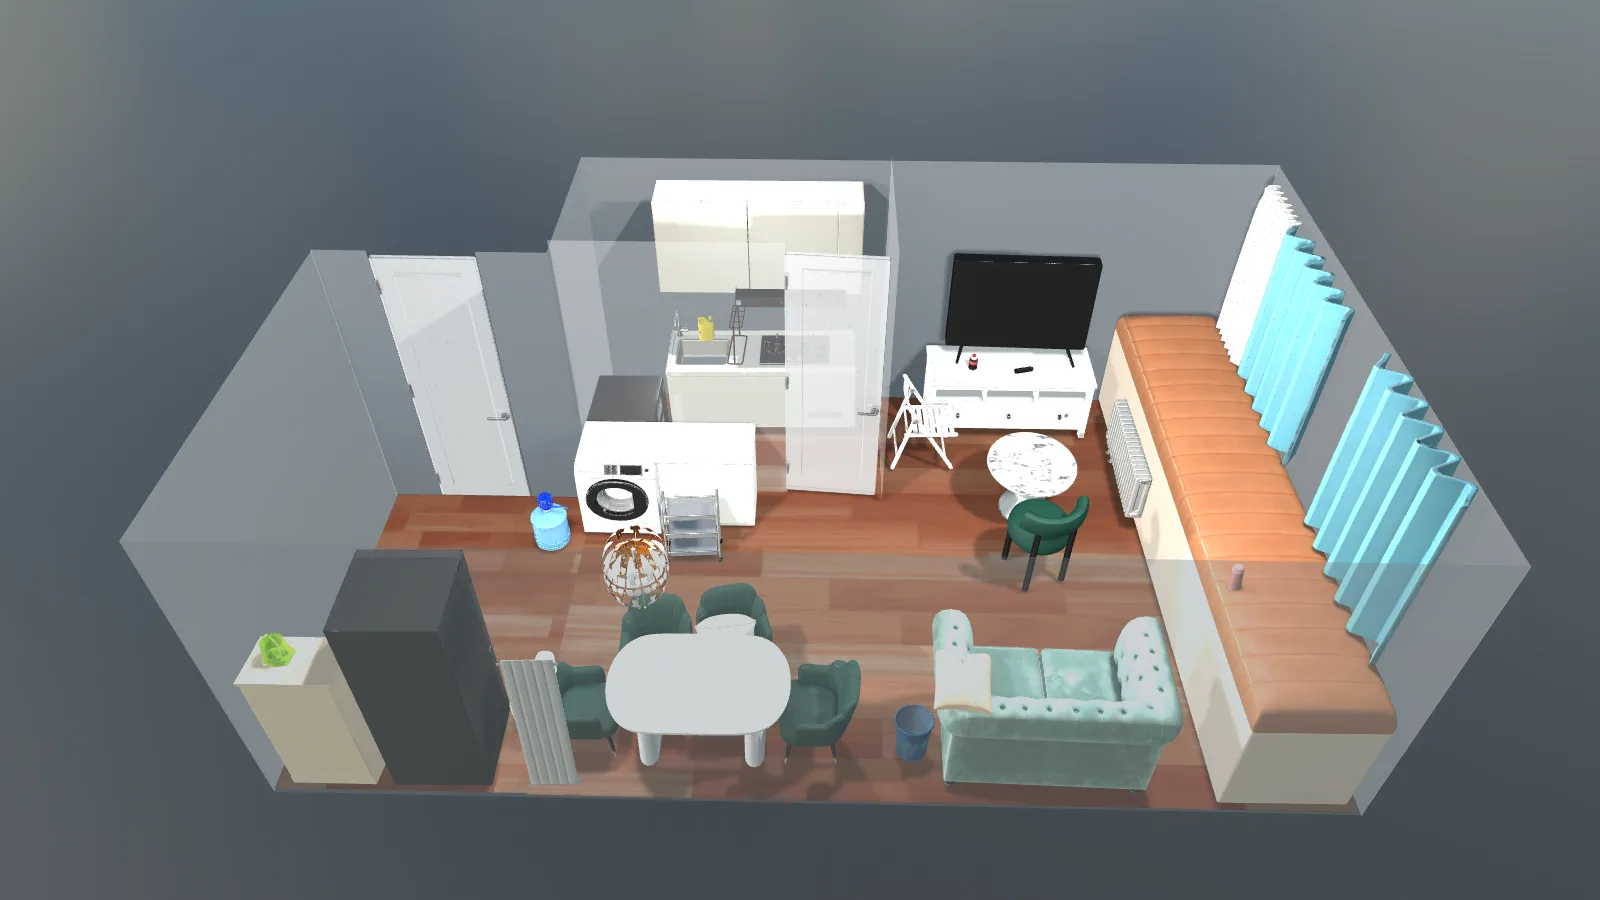
Lucida est un système de modélisation de scènes de ByteDance Seed. Il ne s'arrête pas à un nuage de points fusionné : il reconstruit des objets distincts et les replace dans la disposition observée. Chaque meuble reste éditable séparément.
À quoi ressemble la reconstruction
La vidéo officielle montre une capture intérieure transformée en scène reconstruite. Les objets sont des maillages séparés, et non une surface globale inséparable : un format utile aux jumeaux numériques, à la simulation et à l'édition.
Compléter les objets à partir des fragments visibles
Lucida choisit des vues informatives et associe le même objet entre les images. Images de référence, masques, nuages partiels, boîtes 3D et descriptions constituent ses preuves.
La génération crée une image de l'objet sans occlusion, puis un asset 3D complet dont les parties masquées sont complétées.
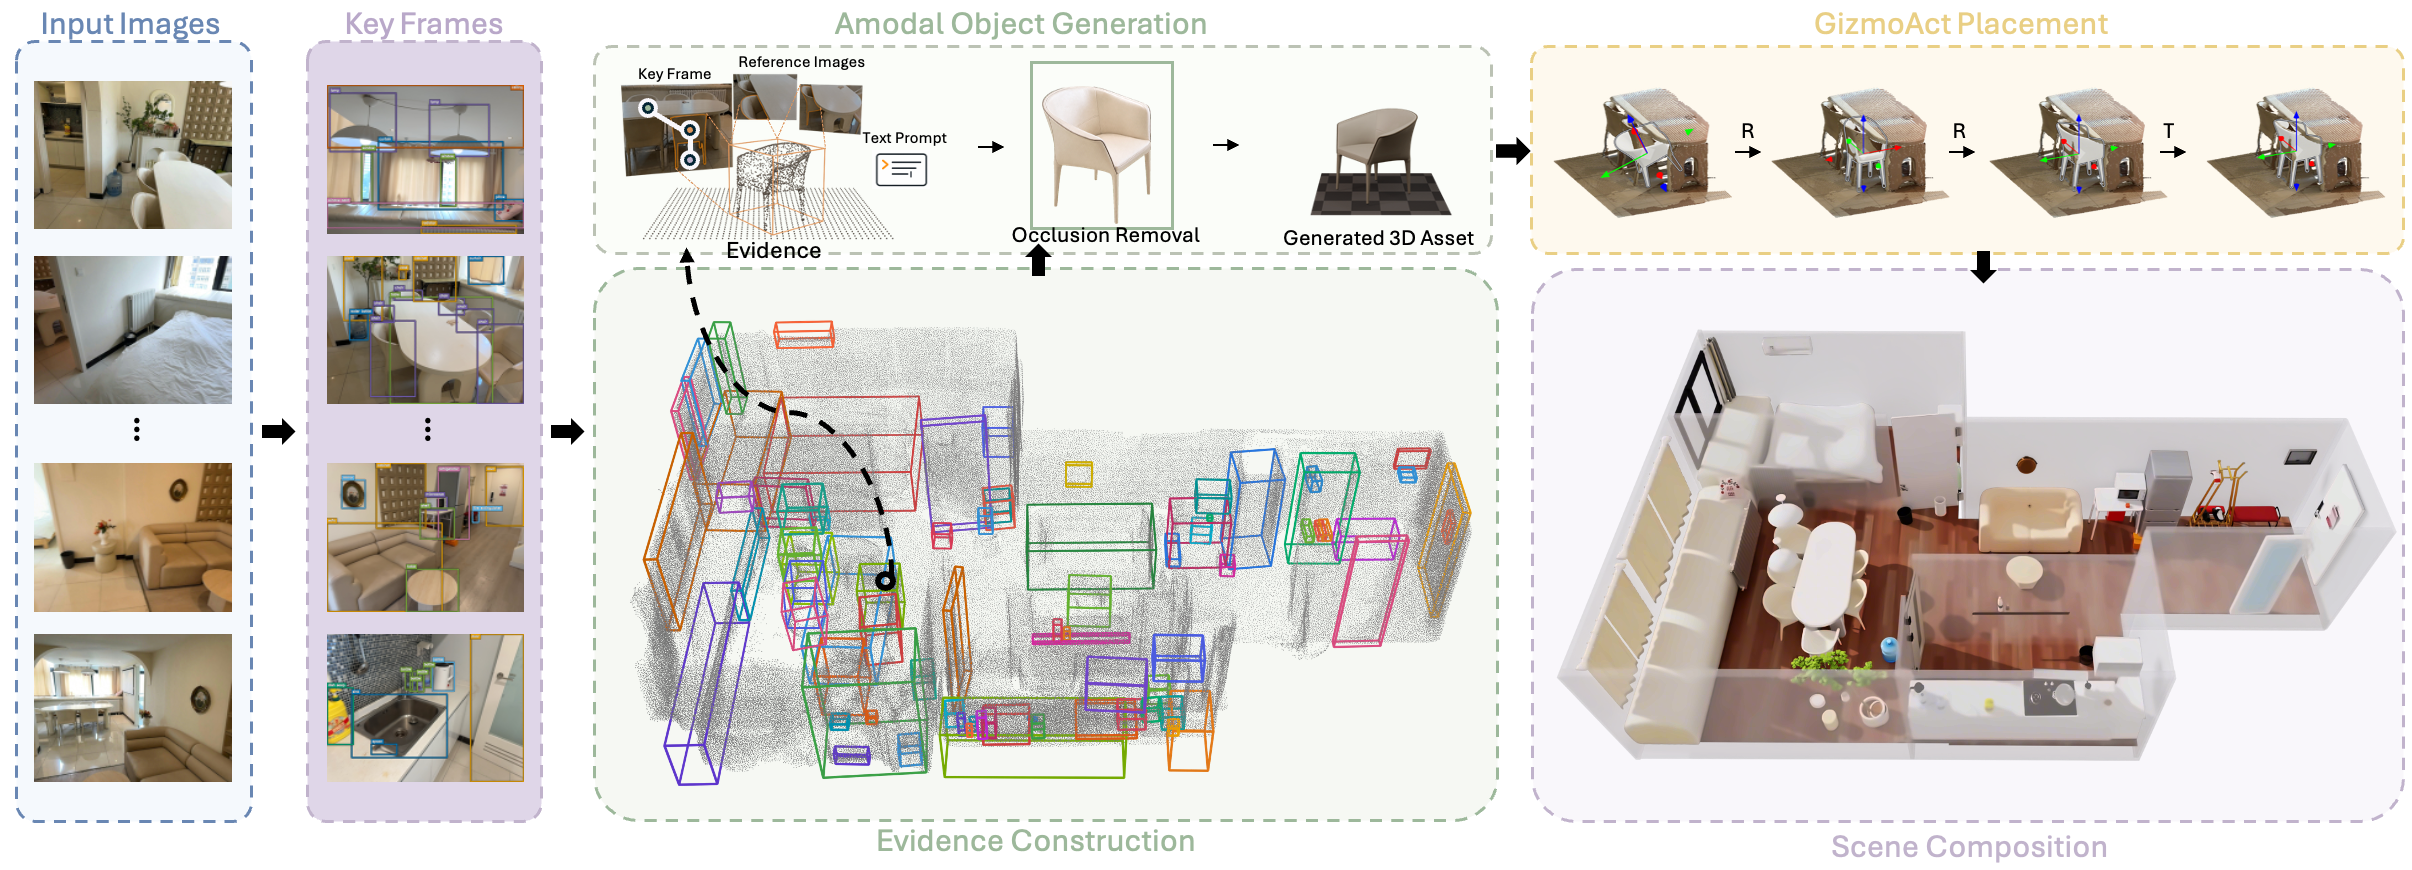
GizmoAct : placer correctement les objets
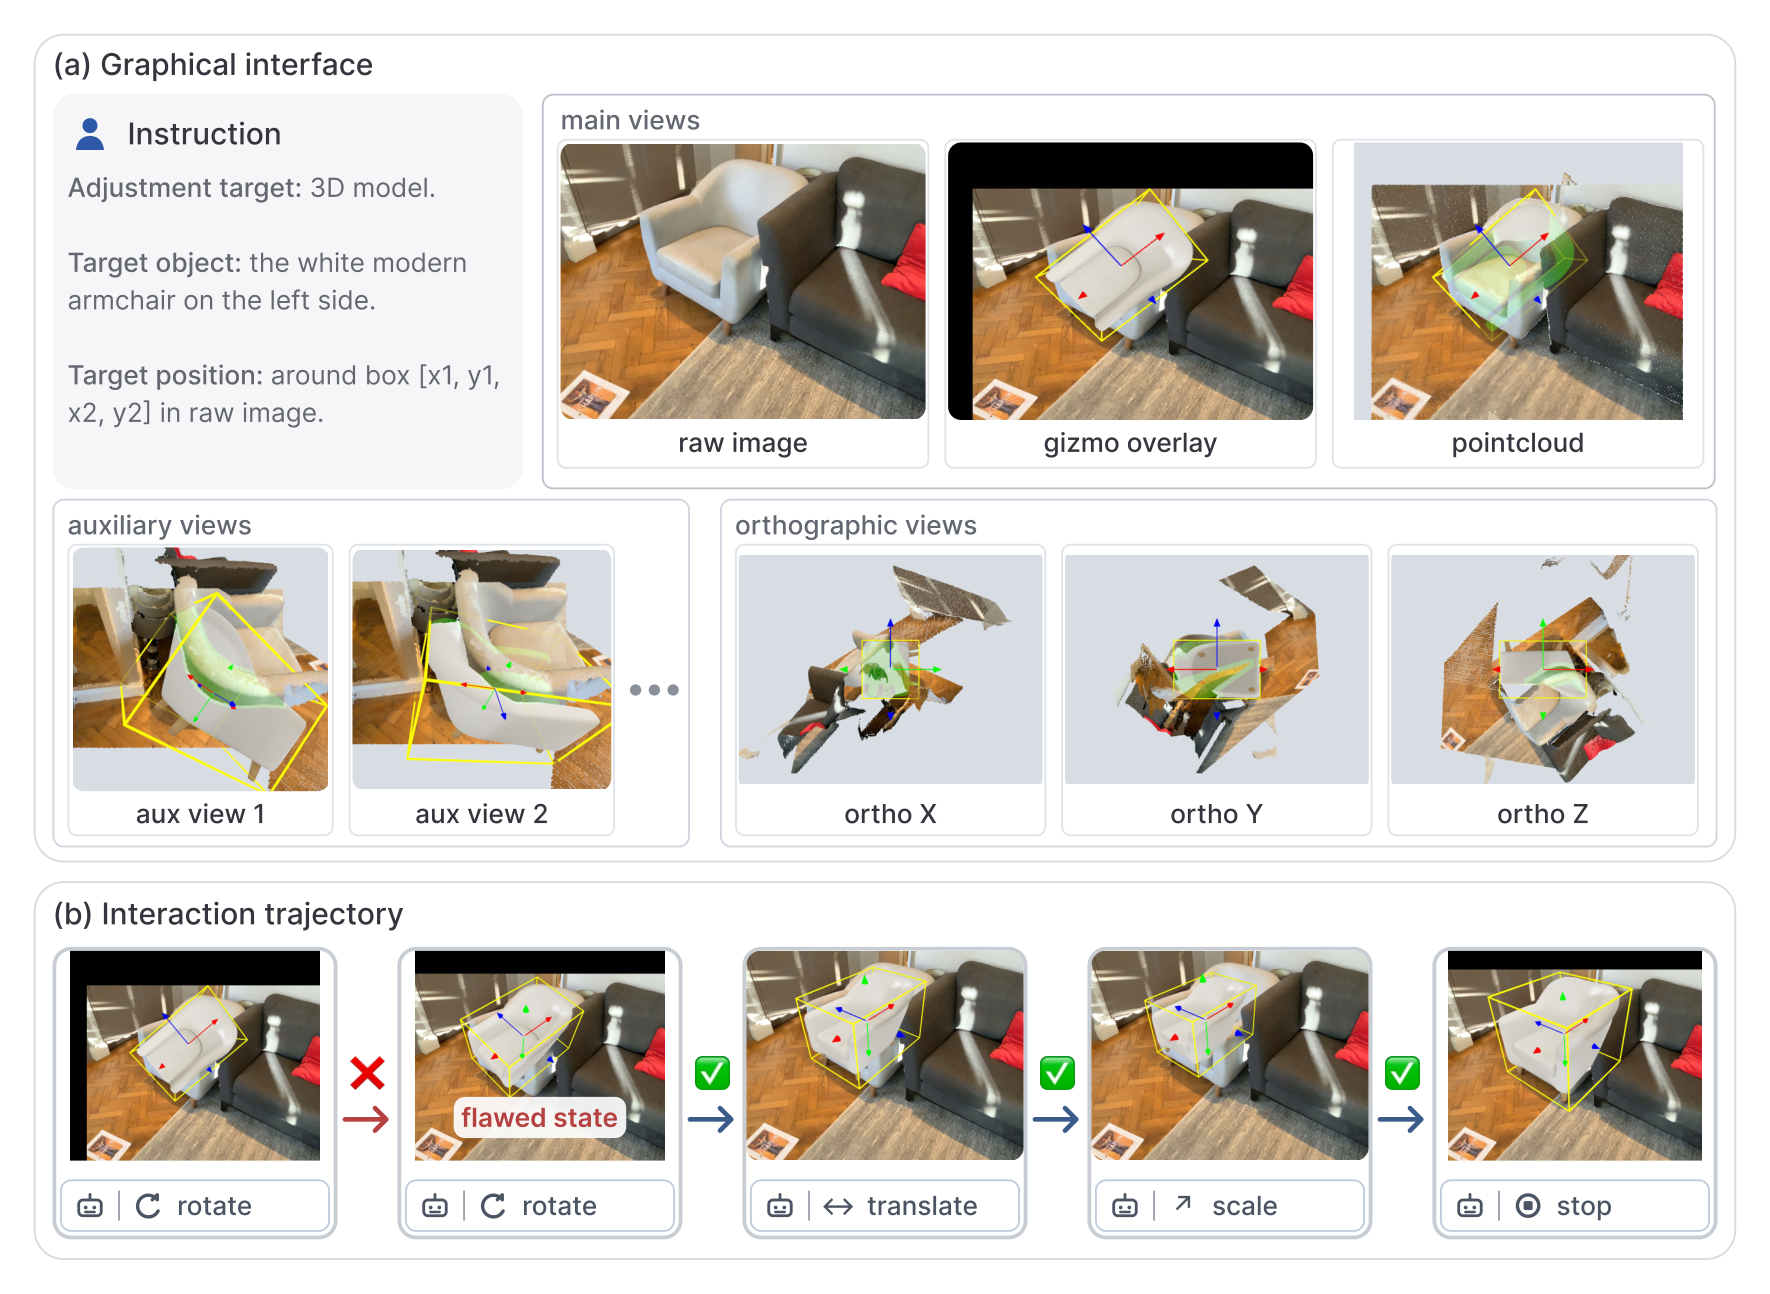
Une forme plausible peut être mal positionnée. Un modèle vision-langage examine rendus, superpositions de points et axes locaux, puis exécute des ajustements de pose.
La boucle confronte chaque modification à la scène capturée. La création et le placement sont séparés pour ne pas exiger une géométrie parfaite dès le départ.
Scène complète ou génération d'un seul objet ?
Pour une pièce ou un environnement real-to-sim, identité, échelle et placement comptent ensemble. Des objets séparés permettent de remplacer un meuble sans reconstruire toute la scène.
Pour un produit, accessoire ou personnage isolé, l'image-vers-3D est plus directe. Utilisez une référence nette quand l'environnement n'est pas nécessaire.
Scènes par objets et nuages de points
| Besoin | Nuage de points | Lucida |
|---|---|---|
| Représentation | Échantillons de surfaces observées | Objets complets distincts |
| Zones masquées | Limitées par les observations | Complétées par génération |
| Édition | Géométrie globale ou segmentation | Maillages individuels |
| Alignement | Recalage géométrique et des caméras | Ajustements visuels en boucle |
Questions fréquentes
Lucida est-il Seed3D 2.0 ?
Non. Lucida compose une scène à partir de plusieurs observations. Seed3D 2.0 génère des objets ; la scène demande aussi association, échelle et placement.
Les zones cachées sont-elles exactes ?
Elles sont générées à partir des preuves disponibles, pas mesurées directement par la caméra.
Quelles données Lucida utilise-t-il ?
Lucida combine plusieurs observations du même intérieur avec leurs poses de caméra. Il associe les objets entre les vues, puis rassemble images de référence, masques, nuages partiels et boîtes 3D pour chaque objet.