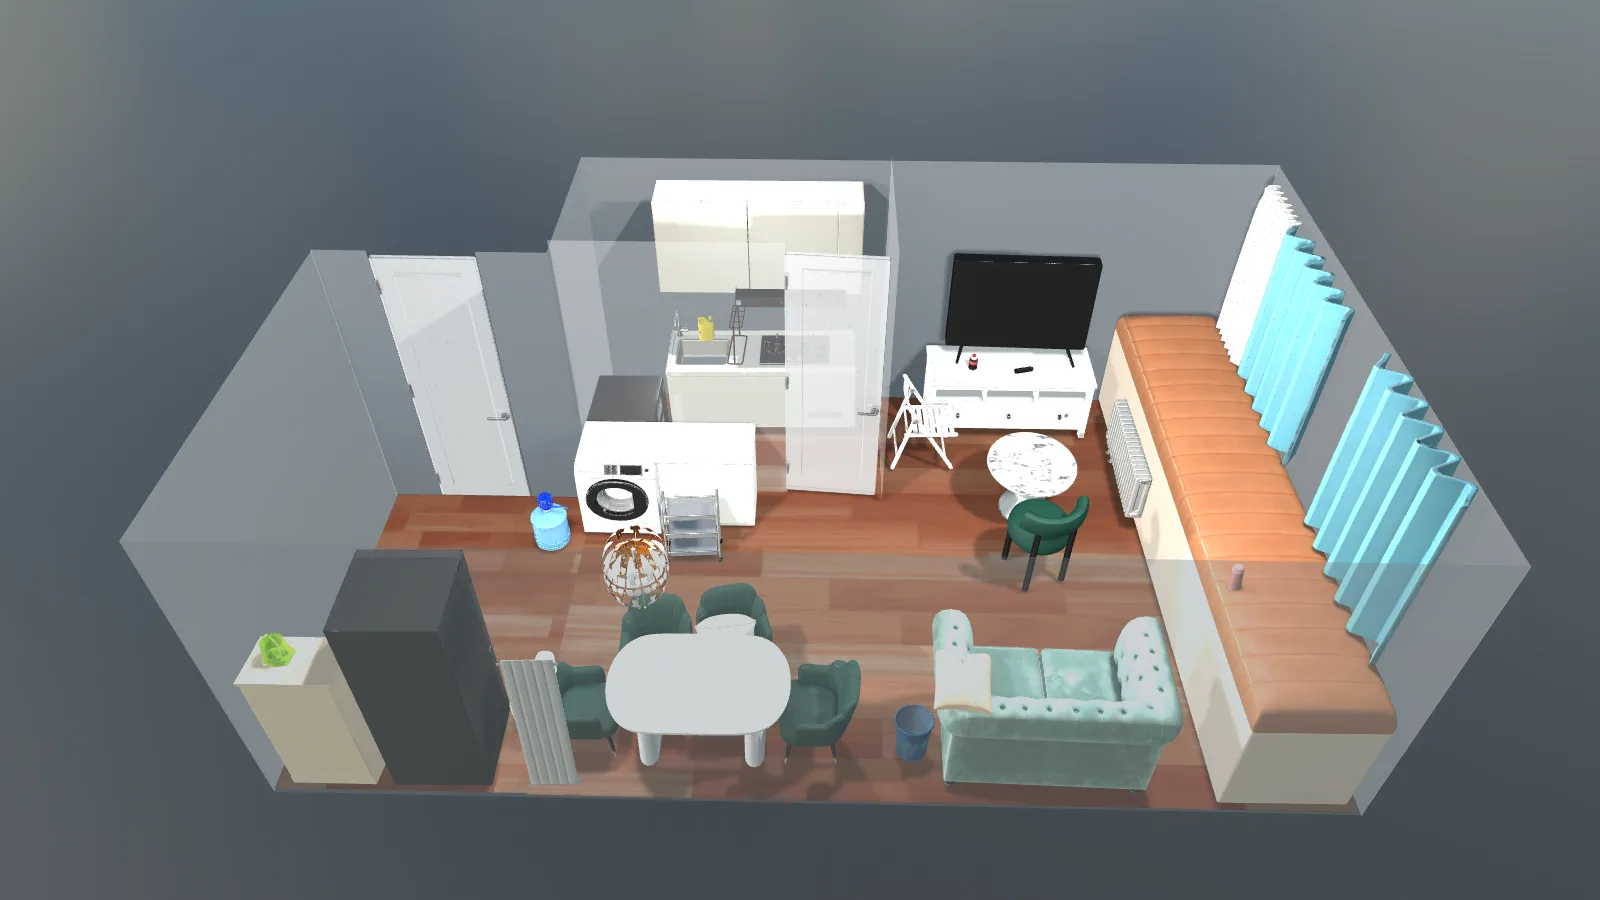
LucidaはByteDance Seedのシーンモデリングシステムです。融合した点群だけでなく、独立した物体を復元し、撮影された配置に並べます。家具を個別に扱える点が重要です。
再構成されたシーンを見る
公式動画は室内撮影からシーン再構成までを紹介しています。結果は分離できない一枚の表面ではなく、独立した物体メッシュで構成されます。デジタルツイン、シミュレーション、シーン編集に適した形式です。
見えている断片から完全な物体を作る
情報量の多い視点を選び、複数の画像に写る同じ物体を対応付けます。参考画像、マスク、部分点群、3Dボックス、説明文を物体ごとの証拠として使います。
生成段階では遮蔽のない物体画像を作り、隠れた部分を補完した完全な3Dアセットへ変換します。
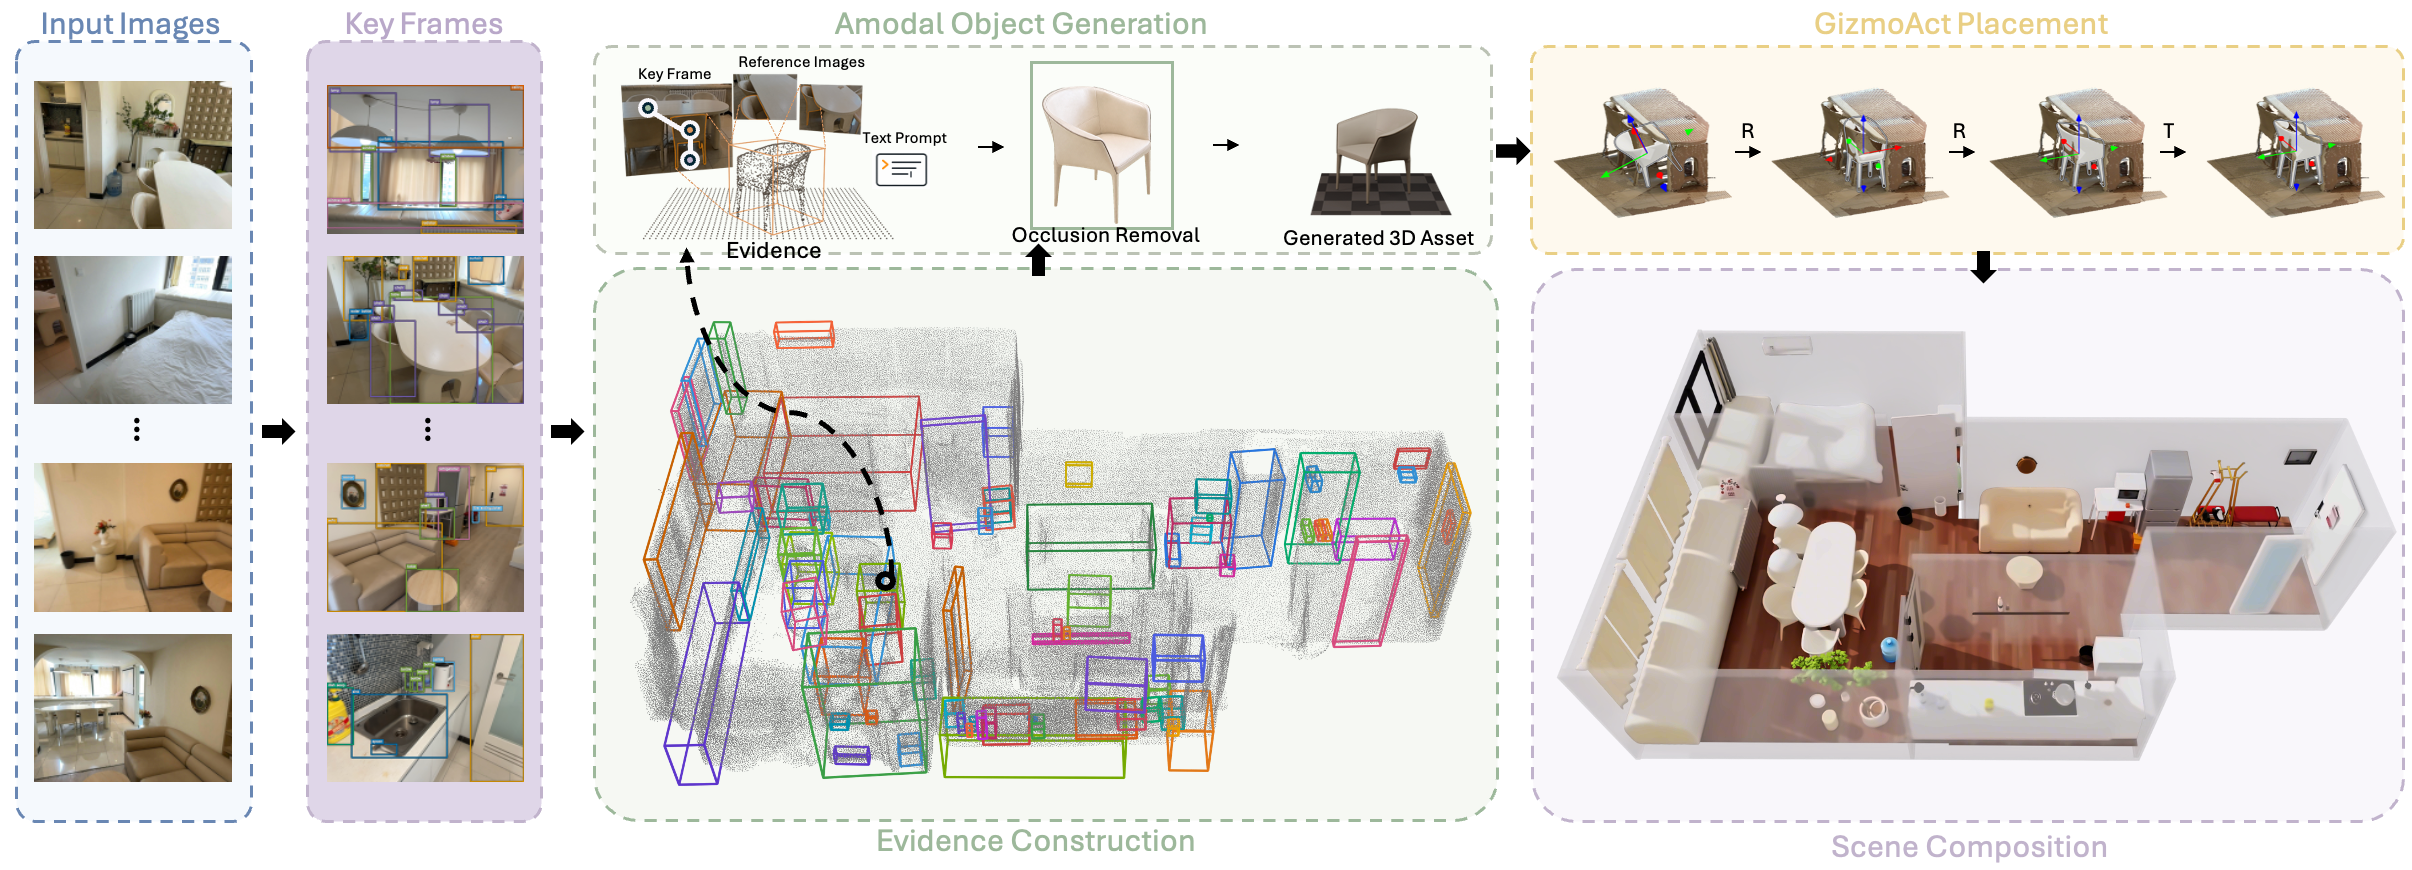
GizmoActで物体の位置と向きを合わせる
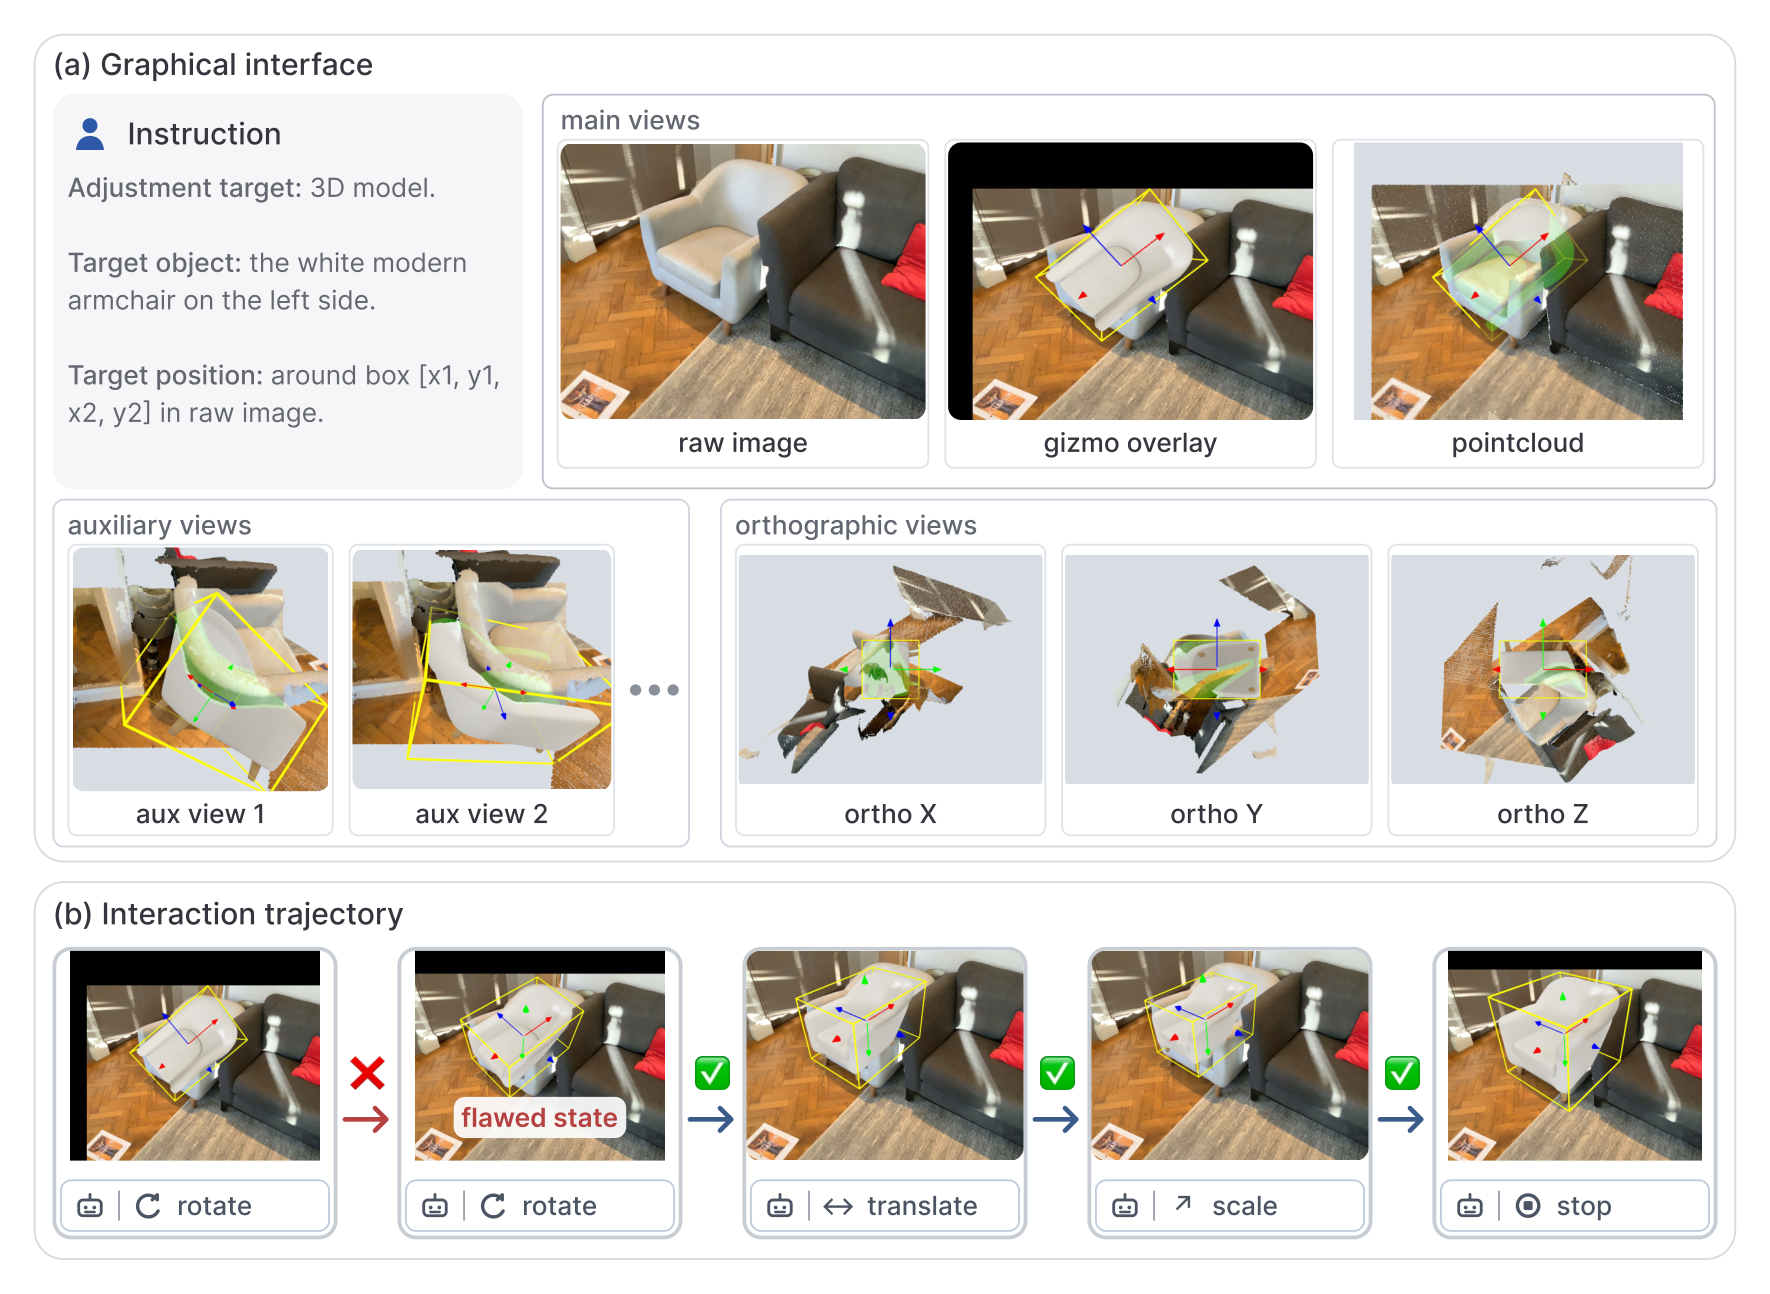
形状が自然でも配置は誤ることがあります。視覚言語モデルがレンダリング画像、点群の重ね合わせ、ローカル軸を確認し、具体的な姿勢編集を実行します。
変更後の結果を元の撮影と比較するループです。生成と配置を分けることで、初期段階から完全な幾何を要求しません。
シーン再構成と単体アセット生成の使い分け
部屋やreal-to-sim環境では、物体の識別、スケール、配置が同時に重要です。独立アセットなら、シーン全体を作り直さず家具を置換・移動できます。
商品、小物、キャラクター一体だけなら画像から3D生成の方が直接的です。背景が不要なら鮮明な被写体画像を用意してください。
物体ベースのシーンと点群再構成
| 目的 | 点群再構成 | Lucida |
|---|---|---|
| 表現 | 観測された表面の点 | 独立した完全な物体 |
| 遮蔽部分 | 撮影された範囲に依存 | 生成段階で推定補完 |
| 編集 | 全体幾何やセグメントの編集 | 物体メッシュを個別編集 |
| 位置合わせ | カメラと幾何の登録 | 視覚フィードバックによる姿勢修正 |
よくある質問
LucidaはSeed3D 2.0ですか?
別のものです。Lucidaは複数の観測からシーンを構成し、Seed3D 2.0はアセットを生成します。シーンには対応付け、スケール、配置も必要です。
見えない部分も正確ですか?
利用できる証拠から生成するため、カメラで直接測定した結果ではありません。
Lucidaはどのような入力を使いますか?
Lucidaは、同じ室内シーンを複数の視点から観測した画像とカメラ姿勢を組み合わせます。視点間で物体を対応付け、参照画像、マスク、部分点群、3Dボックスを物体ごとの情報としてまとめます。