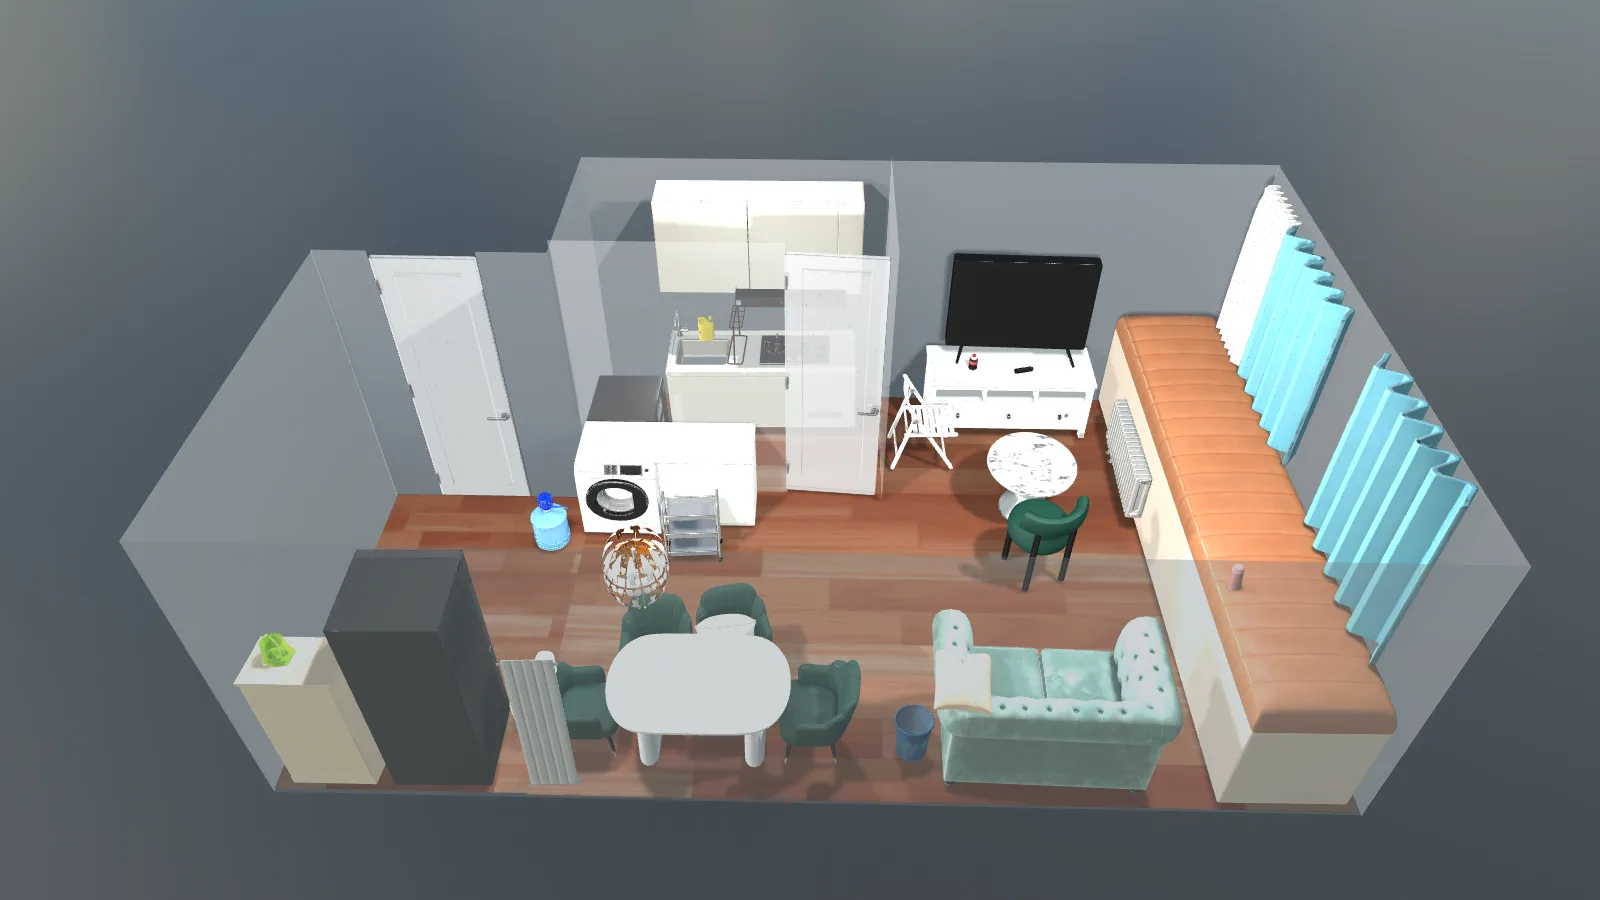
Lucida es un sistema de escenas de ByteDance Seed. En lugar de terminar en una nube de puntos fusionada, recupera objetos independientes y los sitúa como en la captura. Cada mueble conserva su edición individual.
Cómo se ve la reconstrucción
El vídeo oficial sigue una captura interior hasta una escena reconstruida. Los objetos son mallas independientes, no una única superficie inseparable: útil para gemelos digitales, simulación y edición.
De fragmentos visibles a objetos completos
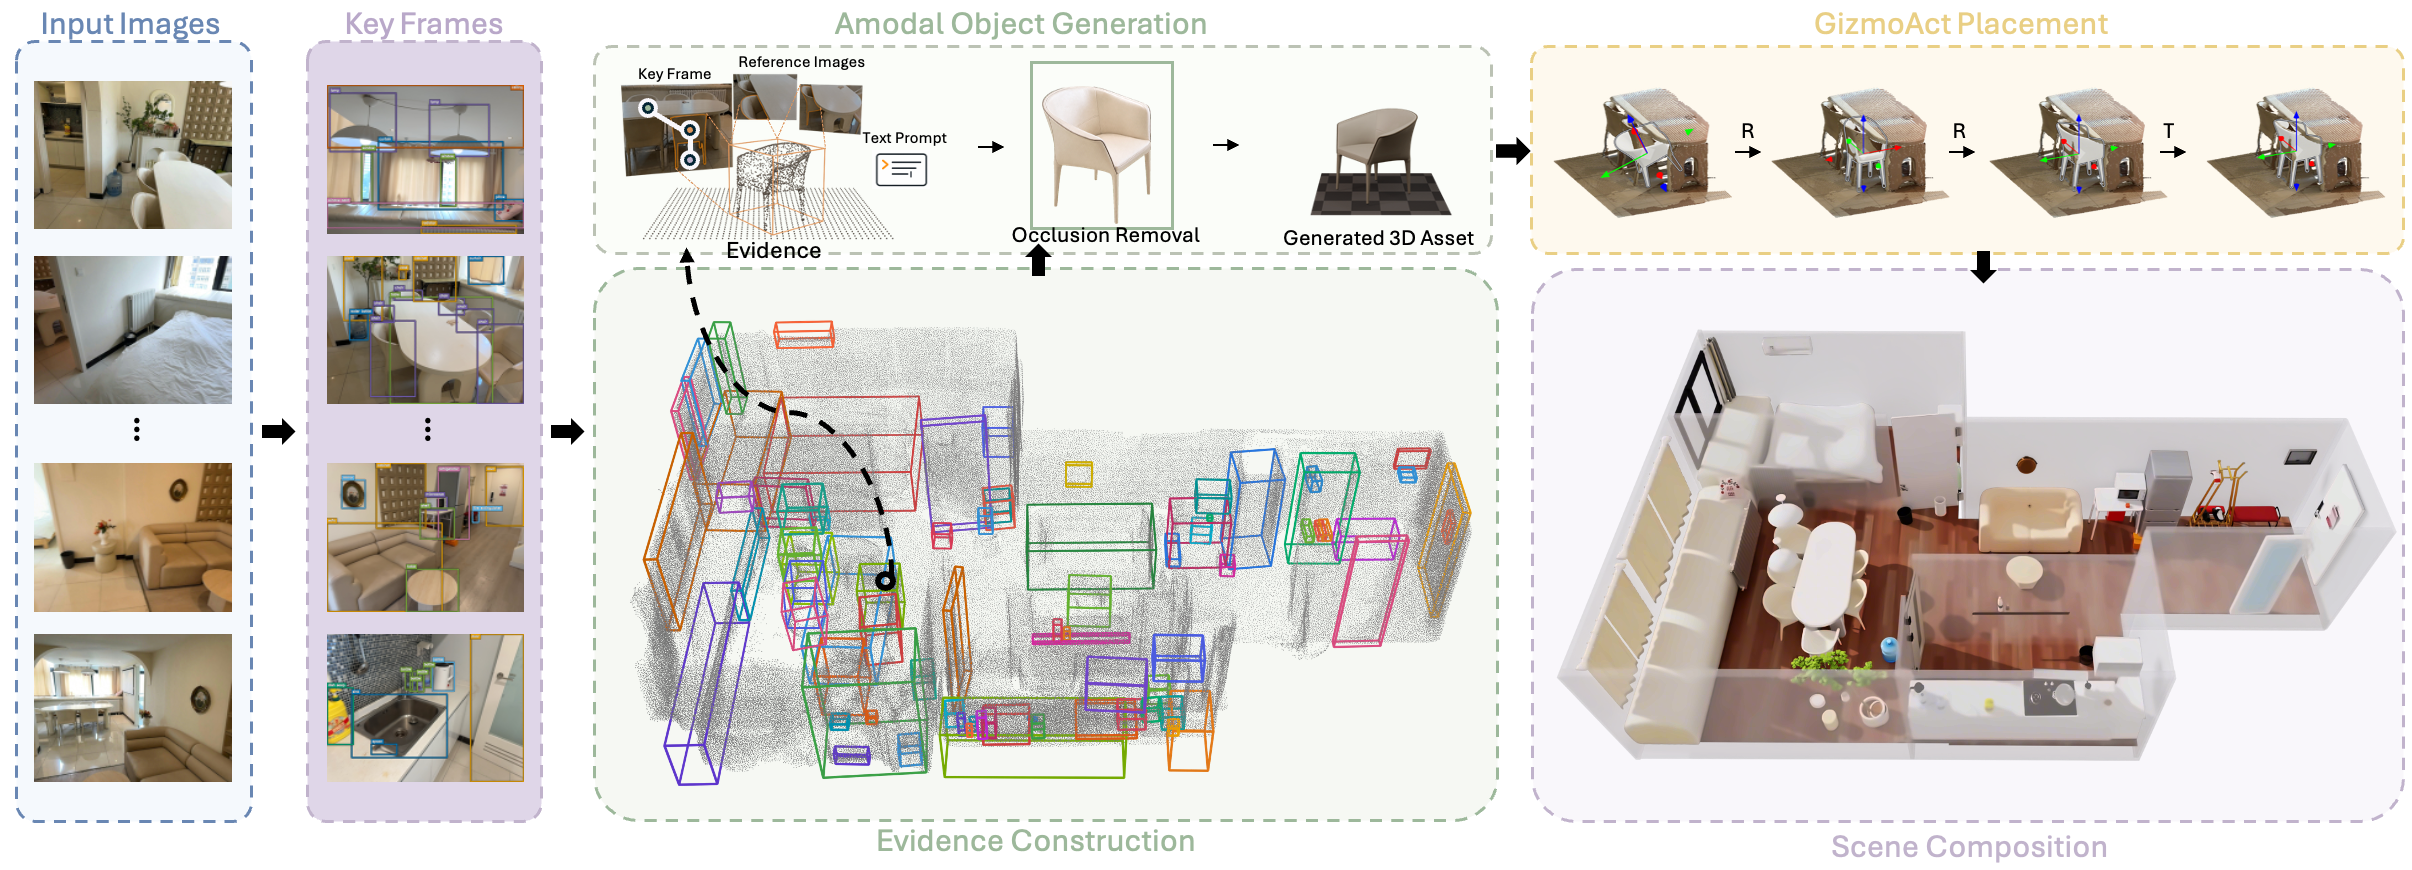
Lucida selecciona vistas informativas y asocia el mismo objeto entre ellas. Imágenes, máscaras, nubes parciales, cajas 3D y descripciones forman su evidencia.
La generación crea una imagen del objeto sin oclusiones y después un recurso 3D completo, rellenando las partes ocultas.
GizmoAct: colocar los objetos correctamente
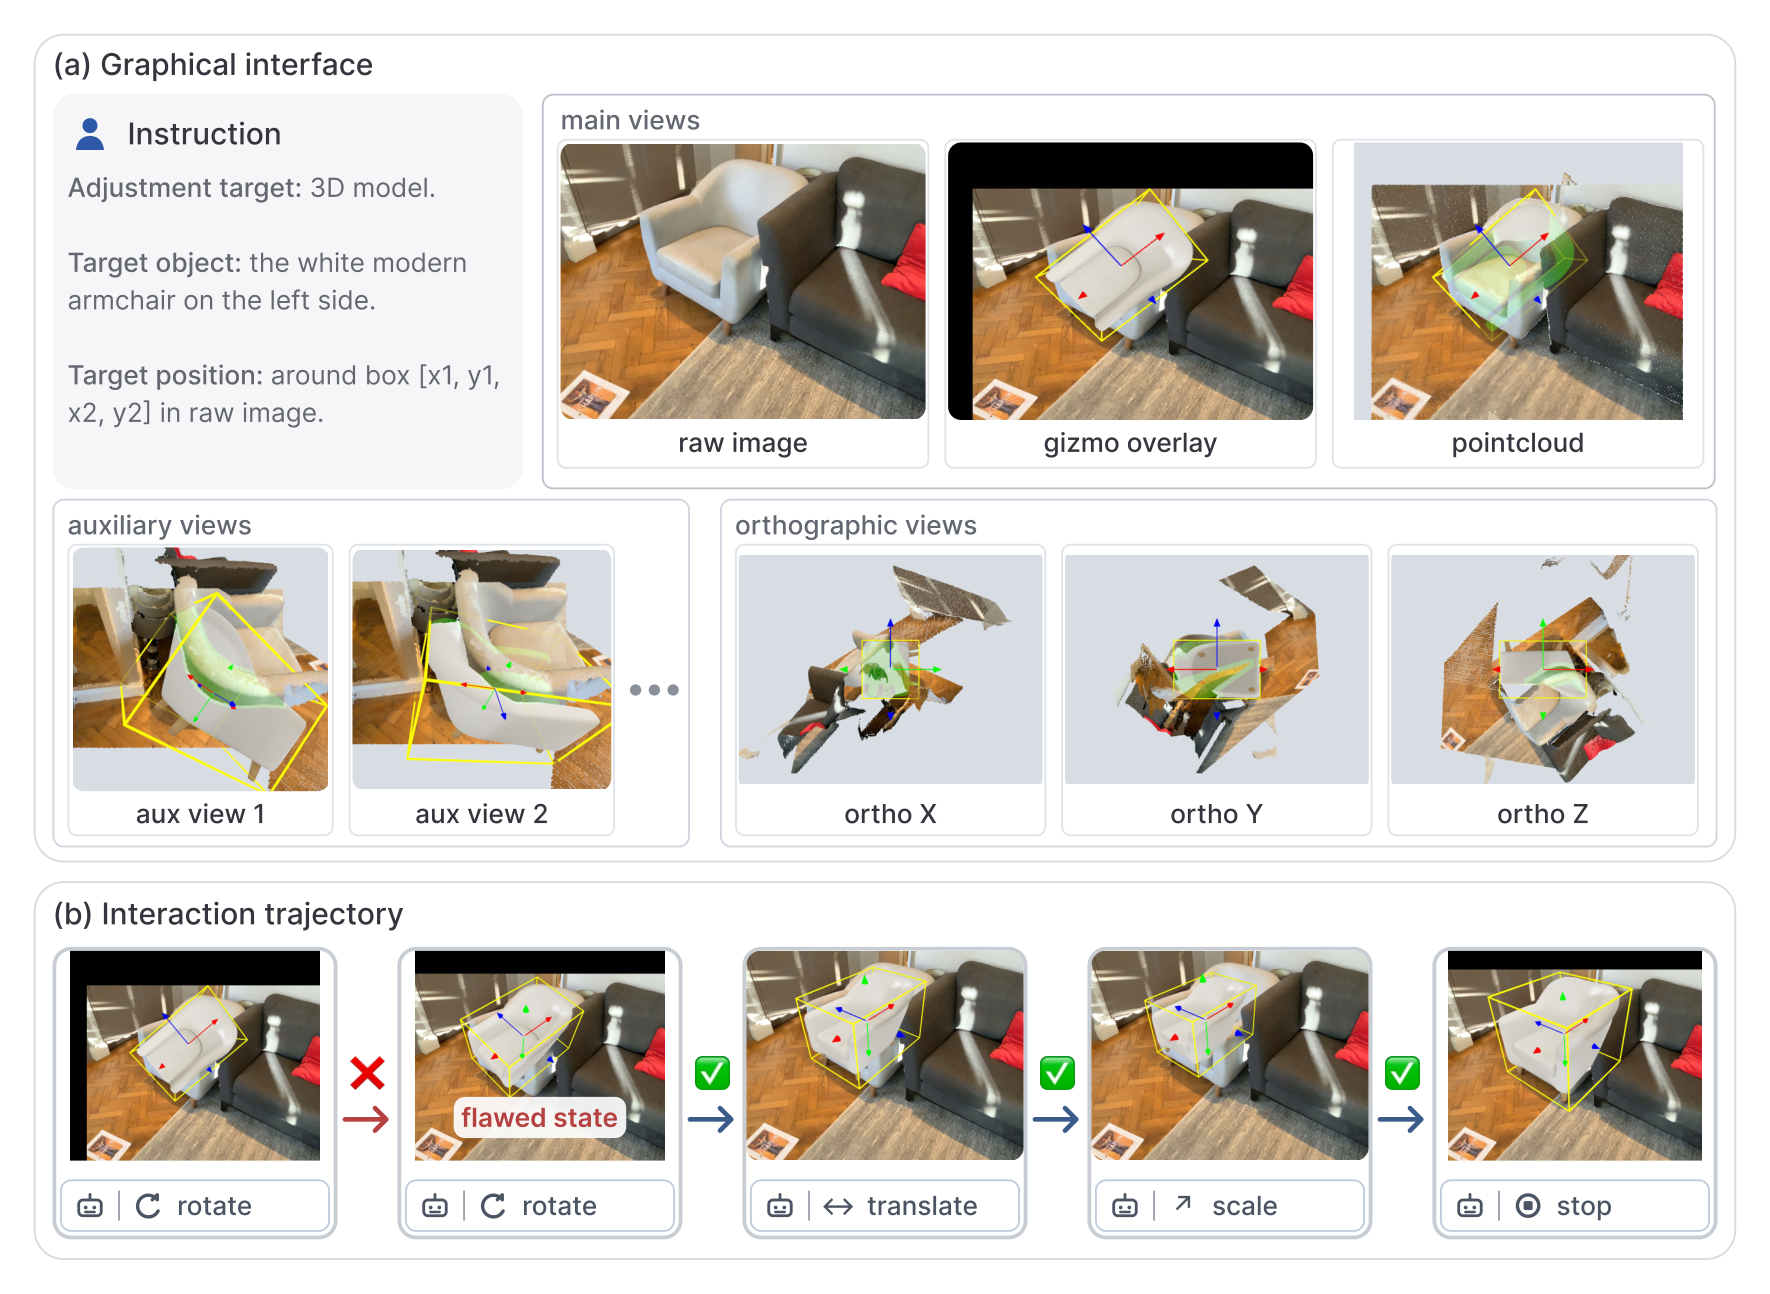
Un modelo correcto puede estar mal orientado. Un modelo visión-lenguaje revisa renderizados, puntos superpuestos y ejes locales antes de ejecutar ajustes de pose.
El bucle contrasta cada cambio con la escena capturada. Separar generación y colocación evita exigir geometría perfecta desde las primeras etapas.
Cuándo reconstruir una escena y cuándo generar un objeto
En habitaciones y entornos real-to-sim importan identidad, escala y posición. Los recursos separados permiten sustituir o mover un objeto sin rehacer la escena.
Para un producto, accesorio o personaje aislado, imagen a 3D es más directo. Prepara una referencia clara si no necesitas el entorno.
Escenas por objetos frente a nubes de puntos
| Necesidad | Nube de puntos | Lucida |
|---|---|---|
| Representación | Muestras de superficies observadas | Objetos completos independientes |
| Zonas ocultas | Limitadas por las observaciones | Completadas mediante generación |
| Edición | Geometría global o segmentación | Mallas de objetos individuales |
| Alineación | Registro de cámaras y geometría | Refinamiento visual en bucle |
Preguntas frecuentes
¿Lucida es Seed3D 2.0?
No. Lucida compone escenas desde varias observaciones. Seed3D 2.0 genera recursos; una escena también necesita asociación, escala y colocación.
¿Las zonas ocultas son exactas?
Se generan a partir de la evidencia disponible, no se miden directamente con la cámara.
¿Qué entradas utiliza Lucida?
Lucida combina varias observaciones del mismo interior con sus poses de cámara. Asocia los objetos entre vistas y reúne imágenes de referencia, máscaras, nubes parciales y cajas 3D para cada objeto.