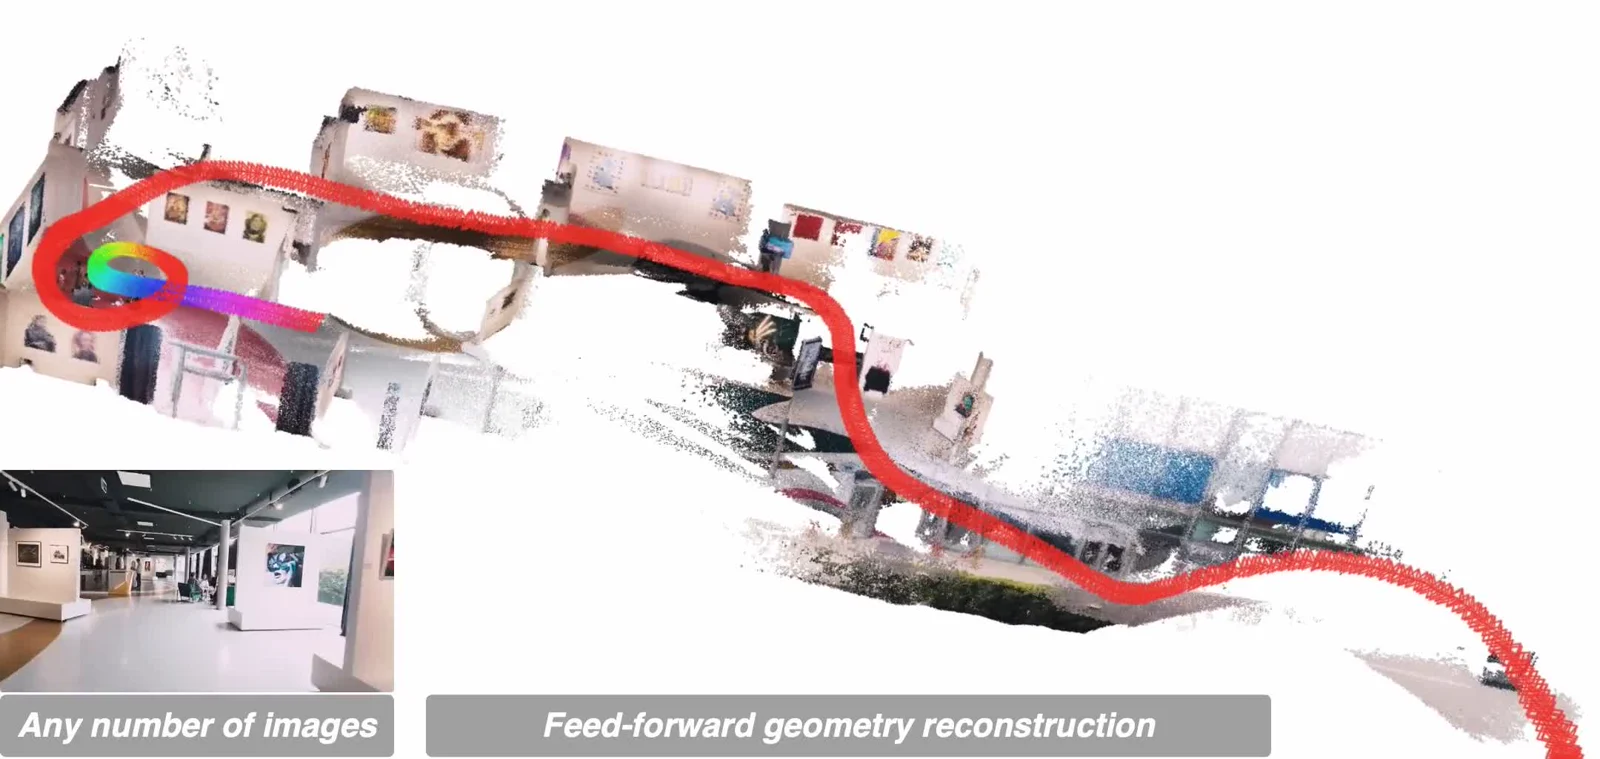
ByteDance SeedのDA3は、深度と光線の統一表現で視点間の一貫した幾何を推定します。未知のカメラにも既知の姿勢にも対応し、シーン収録、空間分析、新視点レンダリングに利用できます。
DA3が復元する情報
単画像では深度を推定し、複数視点では共通の幾何制約とカメラ推定が加わります。動画はサンプリングしたフレームとして処理します。
出力は深度、信頼度、カメラ内部・外部パラメータです。ガウシアンヘッドを持つモデルは、新視点描画用の3Dガウシアンも出力します。
モデルの選び方
複数視点モデルはSmall、Base、Large、Giant。Mono-Largeは相対深度、Metric-Largeは実尺度、Nestedは複数視点幾何とメートル単位のスケールを組み合わせます。
Giant、Large、Nestedは更新版の-1.1を優先します。ガウシアン出力はGiantとNestedに対応し、全モデル共通ではありません。長い動画には滑動窓方式のDA3-Streamingが利用できます。
画像・動画を処理する
PyTorch環境でリポジトリをインストールします。以下のコマンドはNested 1.1で画像フォルダを処理し、数値データとGLBシーンを書き出します。初回に重みをダウンロードします。
動画はda3 video path/to/video.mp4と--fpsで処理します。少数フレームで重なりと信頼度を確認してから範囲を増やすと扱いやすくなります。da3 backendは連続処理でモデルを保持します。
git clone https://github.com/ByteDance-Seed/Depth-Anything-3
cd Depth-Anything-3
pip install -e .

da3 auto path/to/images \
  --model-dir depth-anything/DA3NESTED-GIANT-LARGE-1.1 \
  --export-format mini_npz-glb \
  --export-dir output
出力を次の工程へ
GLBは色付き点群と任意のカメラ線枠を含むシーンです。自動的に整った閉じた物体メッシュになるわけではありません。深度やカメラ配列を再利用するならNPZが適しています。
ガウシアンPLYや描画画像には対応モデルと追加依存関係が必要です。家具などを別々に編集したい場合、Lucidaは物体ごとの復元と配置を行う別の手法です。
DA3、Depth Anything 2、Lucidaの違い
| ツール | 主な入力 | 用途 |
|---|---|---|
| Depth Anything 3 | 単画像・複数視点・動画 | 整合した深度・カメラ・幾何。対応モデルは3Dガウシアンも出力 |
| Depth Anything 2 | 単画像 | 単眼深度推定 |
| Lucida | 姿勢付きの室内観測 | 個別オブジェクトの復元と配置 |
よくある質問
カメラ姿勢は事前に必要ですか?
不要です。複数視点モデルはカメラを推定できます。校正済みの姿勢があれば、条件として入力できます。
すべてのモデルがメートル単位ですか?
いいえ。Nestedは実尺度を出力します。Metric-Largeにはリポジトリ記載の焦点距離による補正が必要です。相対深度モデルは直接のメートル計測ではありません。
商用利用できるモデルは?
Base、Small、Metric-Large、Mono-LargeはApache 2.0です。Giant、Large、NestedはCC BY-NC 4.0です。利用する重みのライセンスを確認してください。