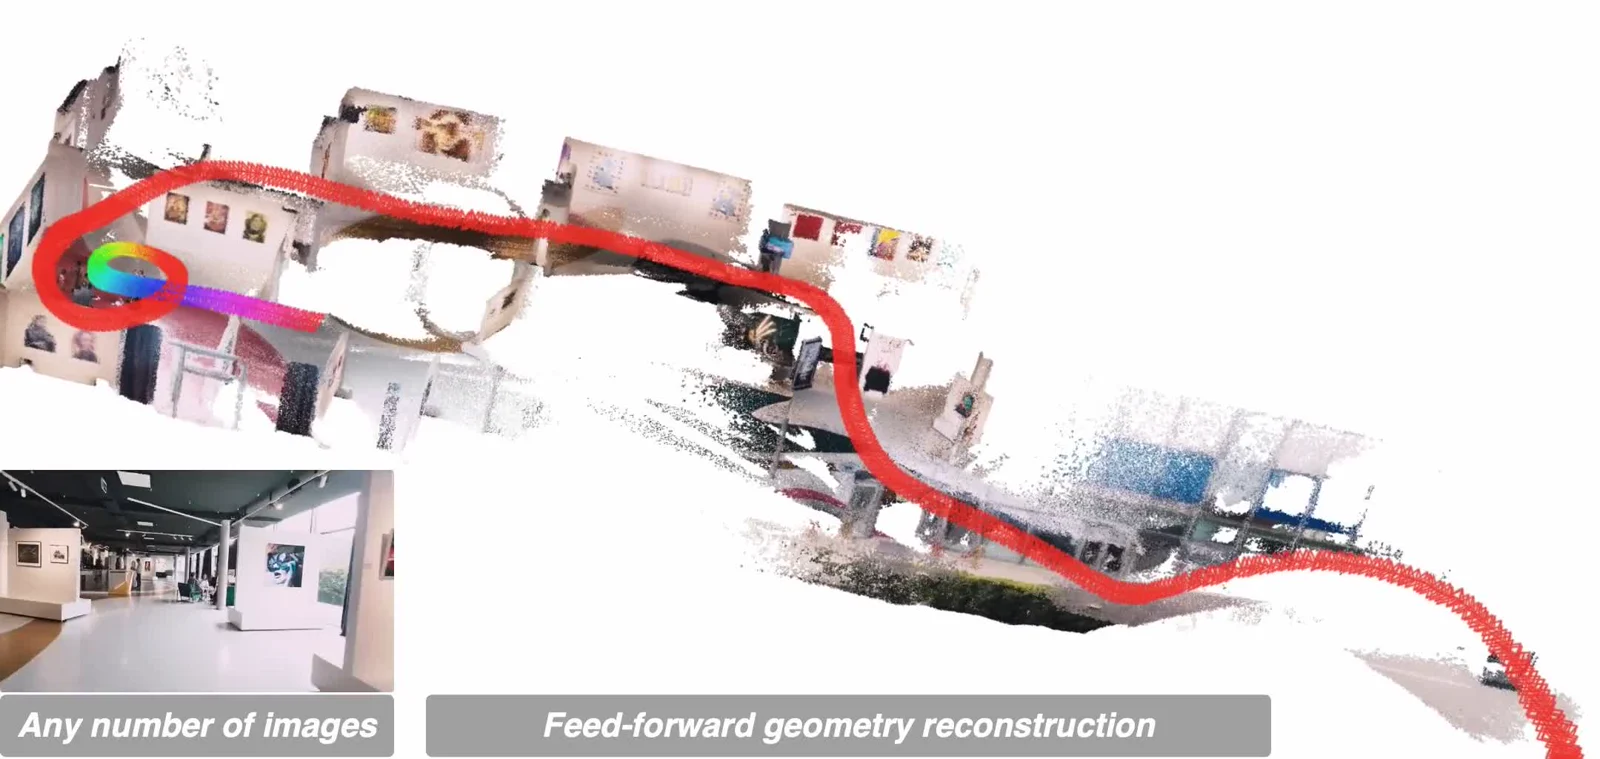
Développé par ByteDance Seed, DA3 estime une géométrie cohérente entre les vues grâce à une représentation profondeur-rayon. Il accepte des caméras inconnues ou des poses fournies pour la capture de scènes et le rendu de nouveaux points de vue.
Ce que DA3 reconstruit
Une image produit une estimation de profondeur ; plusieurs vues ajoutent des contraintes communes et une estimation des caméras. Une vidéo est traitée comme une série d’images échantillonnées.
Les sorties comprennent profondeur, confiance, paramètres intrinsèques et extrinsèques. Les modèles dotés d’une tête gaussienne produisent aussi des gaussiennes 3D pour de nouveaux points de vue.
Choisir un modèle
La famille multi-vues comprend Small, Base, Large et Giant. Mono-Large estime une profondeur relative monoculaire ; Metric-Large vise l’échelle réelle ; Nested associe géométrie multi-vues et échelle métrique.
Privilégiez les versions -1.1 de Giant, Large et Nested. Seuls Giant et Nested proposent la sortie gaussienne. DA3-Streaming utilise des fenêtres glissantes pour les longues séquences.
Reconstruire des images ou une vidéo
Installez le dépôt dans un environnement PyTorch. La commande ci-dessous traite un dossier avec Nested 1.1 et exporte des données numériques ainsi qu’une scène GLB. Les poids sont téléchargés au premier lancement.
Pour une vidéo, utilisez da3 video path/to/video.mp4 et réglez --fps. Commencez avec peu d’images, vérifiez le recouvrement et la confiance, puis augmentez la couverture. da3 backend conserve le modèle pour les tâches répétées.
git clone https://github.com/ByteDance-Seed/Depth-Anything-3
cd Depth-Anything-3
pip install -e .

da3 auto path/to/images \
  --model-dir depth-anything/DA3NESTED-GIANT-LARGE-1.1 \
  --export-format mini_npz-glb \
  --export-dir output
Exploiter les résultats
Le GLB contient un nuage de points coloré et éventuellement les caméras, pas automatiquement un maillage d’objet fermé et propre. NPZ convient aux traitements qui réutilisent les tableaux de profondeur et de caméras.
Le PLY gaussien et les vues rendues exigent un modèle compatible et les dépendances associées. Lucida privilégie une autre approche : reconstruire et placer séparément les objets d’un intérieur.
DA3, Depth Anything 2 ou Lucida ?
| Outil | Entrée principale | Usage |
|---|---|---|
| Depth Anything 3 | Image, plusieurs vues ou vidéo | Profondeur, caméras et géométrie alignées ; gaussiennes selon le modèle |
| Depth Anything 2 | Une image | Estimation monoculaire de profondeur |
| Lucida | Observations intérieures avec poses | Reconstruction et alignement d’objets séparés |
Questions fréquentes
Faut-il connaître les poses des caméras ?
Non. Les modèles multi-vues peuvent estimer les caméras. Des poses calibrées peuvent aussi conditionner la reconstruction.
Tous les modèles donnent-ils une profondeur en mètres ?
Non. Nested fournit une échelle métrique. Metric-Large nécessite la correction par la focale décrite dans le dépôt ; les modèles relatifs ne mesurent pas directement en mètres.
Quels modèles autorisent un usage commercial ?
Base, Small, Metric-Large et Mono-Large sont publiés sous Apache 2.0. Giant, Large et Nested utilisent CC BY-NC 4.0. Vérifiez la licence du poids choisi.