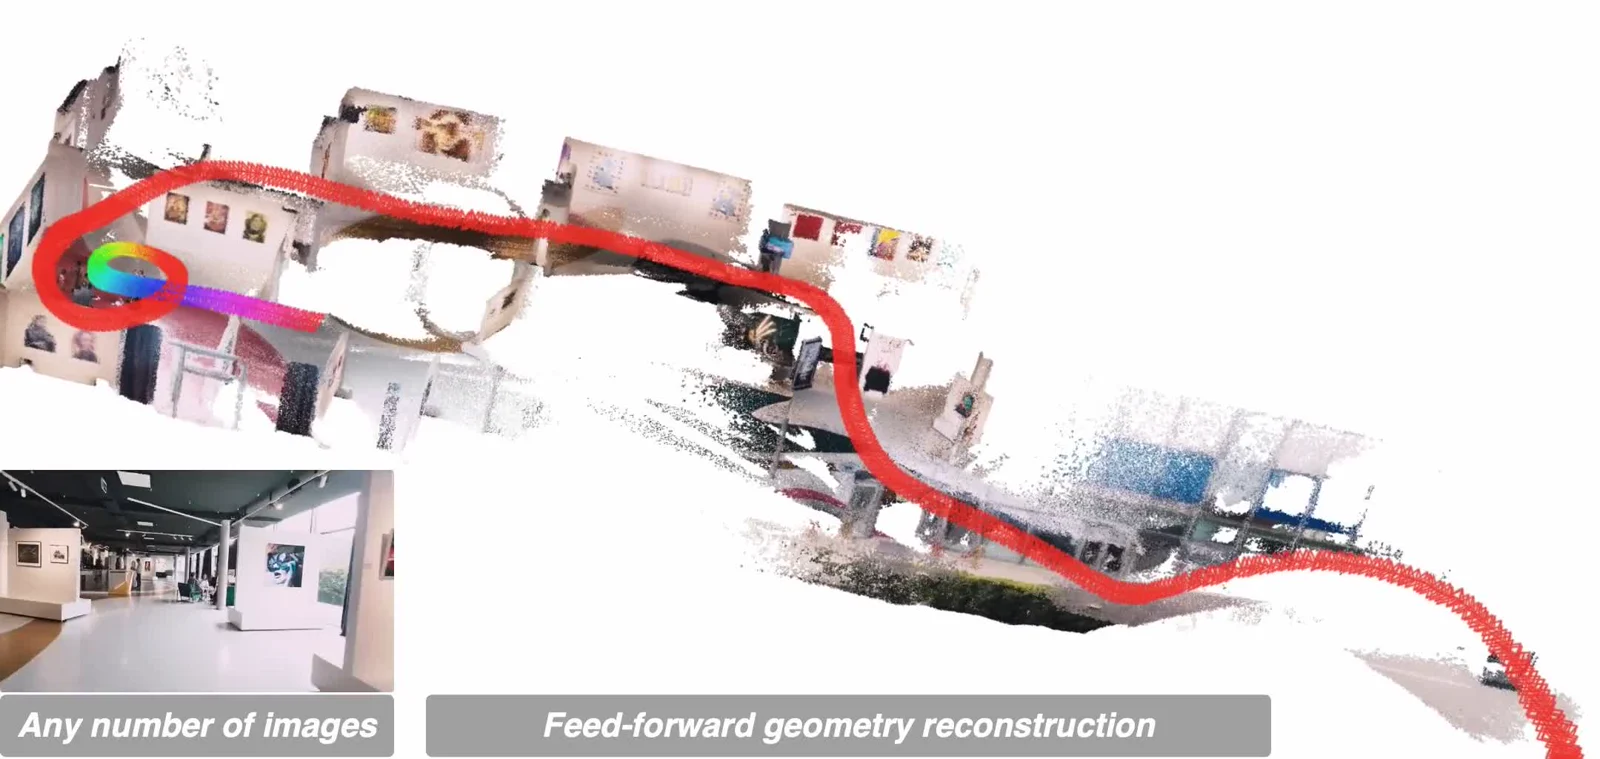
DA3 von ByteDance Seed schätzt ansichtsübergreifend konsistente Geometrie. Die Tiefen-Strahl-Darstellung unterstützt unbekannte Kameras ebenso wie vorgegebene Posen für Szenenerfassung, Raumanalyse und neue Ansichten.
Was DA3 rekonstruiert
Ein Bild liefert Tiefe; mehrere Ansichten ergänzen gemeinsame geometrische Bedingungen und Kameraschätzungen. Videos werden als ausgewählte Einzelbilder verarbeitet.
Ausgegeben werden Tiefe, Konfidenz sowie intrinsische und extrinsische Kameraparameter. Modelle mit Gauß-Kopf erzeugen zusätzlich 3D-Gaußdarstellungen für neue Blickwinkel.
Den passenden Checkpoint wählen
Die Mehransichtsmodelle heißen Small, Base, Large und Giant. Mono-Large liefert relative Tiefe, Metric-Large zielt auf reale Größen. Nested kombiniert Mehransichtsgeometrie mit metrischer Skalierung.
Bevorzuge die überarbeiteten -1.1-Versionen von Giant, Large und Nested. Gauß-Ausgaben unterstützen Giant und Nested, nicht alle Modelle. DA3-Streaming verarbeitet lange Sequenzen mit gleitenden Fenstern.
Bilder oder Videos verarbeiten
Installiere das Repository in einer PyTorch-Umgebung. Der Befehl nutzt Nested 1.1 für einen Bilderordner und exportiert numerische Daten sowie eine GLB-Szene. Die Gewichte werden beim ersten Aufruf geladen.
Für Videos nutze da3 video path/to/video.mp4 und --fps. Starte mit wenigen Bildern, prüfe Überlappung und Konfidenz und erweitere dann die Abdeckung. da3 backend hält das Modell für weitere Aufträge im Speicher.
git clone https://github.com/ByteDance-Seed/Depth-Anything-3
cd Depth-Anything-3
pip install -e .

da3 auto path/to/images \
  --model-dir depth-anything/DA3NESTED-GIANT-LARGE-1.1 \
  --export-format mini_npz-glb \
  --export-dir output
Ergebnisse weiterverwenden
GLB enthält eine farbige Punktwolkenszene mit optionalen Kameralinien, nicht automatisch ein sauberes, geschlossenes Objektmesh. NPZ eignet sich für die Weiterverarbeitung der Tiefen- und Kameraarrays.
Gauß-PLY und gerenderte Ansichten benötigen geeignete Checkpoints und Zusatzabhängigkeiten. Lucida rekonstruiert und platziert dagegen einzelne Innenraumobjekte, wenn getrennt editierbare Assets gefragt sind.
DA3, Depth Anything 2 oder Lucida?
| Werkzeug | Eingabe | Geeignet für |
|---|---|---|
| Depth Anything 3 | Ein Bild, mehrere Ansichten oder Video | Ausgerichtete Tiefe, Kameras und Geometrie; je nach Modell 3D-Gaußdarstellungen |
| Depth Anything 2 | Ein Bild | Monokulare Tiefenschätzung |
| Lucida | Innenraumaufnahmen mit Posen | Rekonstruktion und Ausrichtung einzelner Objekte |
Häufige Fragen
Sind bekannte Kameraposen erforderlich?
Nein. Mehransichtsmodelle können Kameras schätzen. Kalibrierte Posen lassen sich zusätzlich zur konditionierten Rekonstruktion angeben.
Liefern alle Modelle Tiefe in Metern?
Nein. Nested liefert metrische Tiefe. Metric-Large benötigt die im Repository beschriebene Brennweitenskalierung; relative Modelle liefern keine direkten Meterwerte.
Welche Modelle sind kommerziell nutzbar?
Base, Small, Metric-Large und Mono-Large stehen unter Apache 2.0. Giant, Large und Nested verwenden CC BY-NC 4.0. Prüfe die Lizenz des konkreten Checkpoints.