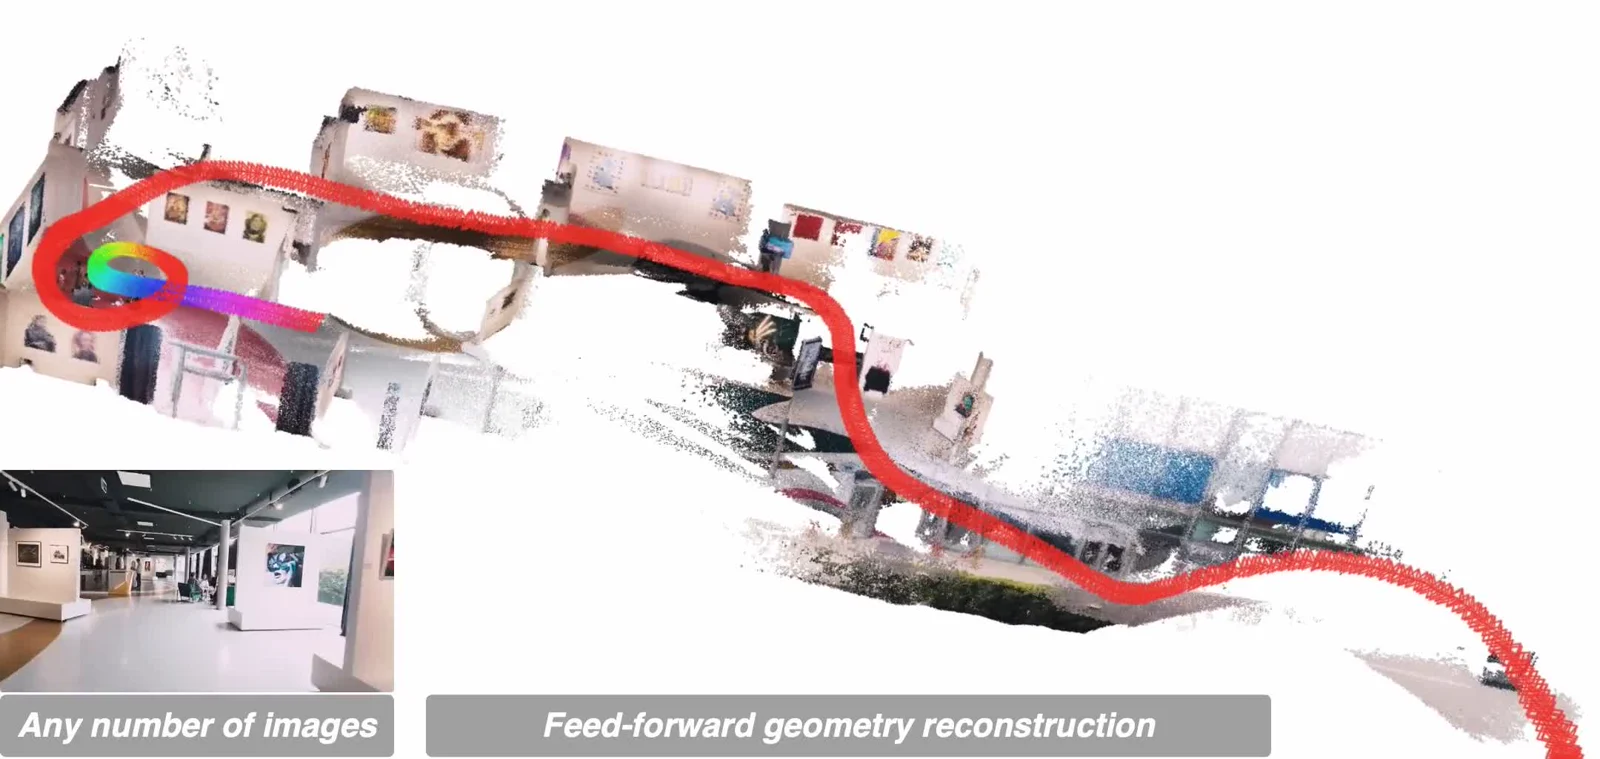
DA3, desarrollado por ByteDance Seed, estima geometría coherente entre vistas mediante una representación de profundidad y rayos. Admite cámaras desconocidas o poses proporcionadas para capturar escenas y renderizar nuevas vistas.
Qué reconstruye DA3
Una imagen permite estimar profundidad; varias vistas añaden restricciones compartidas y estimación de cámaras. El vídeo se procesa mediante fotogramas muestreados.
Las salidas incluyen profundidad, confianza, parámetros intrínsecos y extrínsecos. Los modelos con cabeza gaussiana también producen Gaussianos 3D para nuevas vistas.
Elegir los pesos adecuados
La familia multivista incluye Small, Base, Large y Giant. Mono-Large estima profundidad relativa; Metric-Large busca escala real; Nested combina geometría multivista con escala métrica.
Prioriza las versiones -1.1 de Giant, Large y Nested. Giant y Nested admiten Gaussianos, pero no todos los modelos. DA3-Streaming usa ventanas deslizantes para secuencias largas.
Procesar imágenes o vídeo
Instala el repositorio en un entorno PyTorch. El comando usa Nested 1.1 para procesar una carpeta y exportar datos numéricos y una escena GLB. Los pesos se descargan en el primer uso.
Para vídeo, utiliza da3 video path/to/video.mp4 y --fps. Empieza con pocos fotogramas, revisa solapamiento y confianza y amplía la cobertura. da3 backend mantiene el modelo cargado para tareas repetidas.
git clone https://github.com/ByteDance-Seed/Depth-Anything-3
cd Depth-Anything-3
pip install -e .

da3 auto path/to/images \
  --model-dir depth-anything/DA3NESTED-GIANT-LARGE-1.1 \
  --export-format mini_npz-glb \
  --export-dir output
Aprovechar las exportaciones
El GLB contiene una nube de puntos coloreada y cámaras opcionales, no automáticamente una malla de objeto limpia y cerrada. NPZ sirve para reutilizar matrices de profundidad, confianza y cámaras.
El PLY gaussiano y las vistas renderizadas requieren pesos compatibles y dependencias adicionales. Lucida sigue otra ruta para interiores: reconstruye y coloca cada objeto por separado.
¿DA3, Depth Anything 2 o Lucida?
| Herramienta | Entrada | Uso principal |
|---|---|---|
| Depth Anything 3 | Imagen, varias vistas o vídeo | Profundidad, cámaras y geometría alineadas; Gaussianos según el modelo |
| Depth Anything 2 | Una imagen | Estimación monocular de profundidad |
| Lucida | Observaciones interiores con poses | Reconstrucción y alineación de objetos separados |
Preguntas frecuentes
¿Necesita poses de cámara conocidas?
No. Los modelos multivista estiman cámaras. Las poses calibradas también pueden proporcionarse para condicionar la reconstrucción.
¿Todos los modelos dan profundidad en metros?
No. Nested da escala métrica. Metric-Large necesita el ajuste por distancia focal descrito en el repositorio; los modelos relativos no dan mediciones directas en metros.
¿Qué modelos permiten uso comercial?
Base, Small, Metric-Large y Mono-Large usan Apache 2.0. Giant, Large y Nested usan CC BY-NC 4.0. Comprueba la licencia de los pesos concretos.